原来卡脖子的从来不是学生,是没有可用的数据场景
之前找合作工厂要数据,人家也配合,要么给脱敏后的月度汇总表,要么把设备导出的零散csv打包发过来。学生拿到手,全是乱的。要主轴振动数据,混在整线的传感器日志里,自己筛要筛两三天,等筛完,实训时间都过去一半了。要不同负载下的齿轮箱温度数据,人家只给了年平均,根本用不到结构优化里。
我们教机械设计,教了一辈子参数计算、结构建模,可从来没教过学生,去哪找真实的工业数据,怎么用真实数据修正设计。这缺口不补上,学生出去到企业,还是要重新花一两年踩坑。
就是那时候打定主意,要搭个自己用的支撑平台。
第一次踩坑:把底座做成了没分类的垃圾桶
一开始思路错了。找计算机系的学生帮忙搭了个空数据库,把攒到的几十万条物联数据一股脑导进去,就觉得完事了。
用了一次就发现不对。学生做主轴结构优化,要连续7天10Hz采样的振动数据,平台里存的全是整点均值,根本支撑不了仿真分析。学生做故障预警设计,要故障发生前后2小时的全参数曲线,正常数据和故障数据混在一块,翻一下午都找不对。
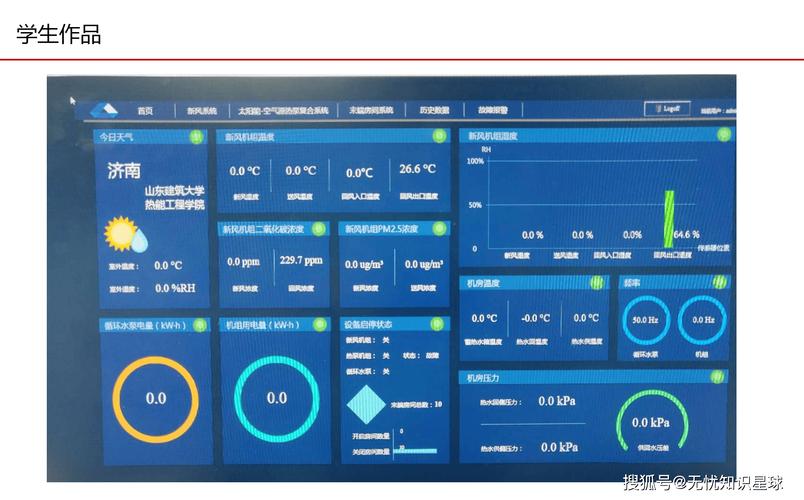
熬了三个晚上整理数据,差点熬秃。才想明白,我们要的不是存数据的仓库,是面向机械设计场景的服务底座。学生要什么,能快速捞出来,能直接对接常用的仿真工具,不用自己转格式洗数据,这才是支撑,不是堆数据。
推倒重来。把所有数据按设计场景重新标引:结构优化要什么数据、可靠性设计要什么数据、数字孪生建模要什么数据,全部分门别类,还给常用的SolidWorks、Ansys做了直接调用的插件,学生不用再导来导去浪费时间。
三个没改的“缺点”,反而成了最有用的设计
改到第三版的时候,有三个地方一开始大家说要调,我后来想想,留下了。
第一个,开放学生上传入口,允许学生把自己做实验测的数据传上去标注共享。一开始怕学生传错数据,把平台搞乱,还加了审核,后来发现根本不用太担心。学生做小样机实测出来的数据,都是同规模同场景的,下一届学生做类似设计,反而比大厂过来的脱敏数据好用,参考性更强。现在平台里,学生上传的数据量已经超过了我攒的工厂数据,挺有意思。
第二个,只对本校实训开放,不做对外开源,所有数据只能调用,不能批量下载。一开始有人说做出来就要放出去赚影响力,可合作工厂给数据的时候签了保密协议,只能用于教学,这底线不能碰。再说了,让学生在上学的时候就知道工业数据有保密要求,有产权,这不比教多少设计规范都有用?
第三个,没做AI自动生成设计方案的功能,只给数据,不给结论。现在好多平台都主打一键出图一键优化,我偏不。学生来上实训,是学怎么分析数据怎么改设计,不是拿现成的方案凑学分。哪怕学生拿了数据算出来错了,那也是他自己的收获,比拿个对的结果却啥也没懂强。
说实话,搭这个平台,一开始就是为了帮学生解决没数据用的小问题。做着做着才发现,它其实是把工厂真实的设计逻辑搬进了课堂。之前学生做设计,都是教材给好参数,算完交作业,路径都是铺好的。现在不一样了,你要自己找对应工况的数据,你要判断数据合不合理,你要拿真实运行出来的结果调你的设计,这才是真本事。
不过话说回来,现在缺口还很大。重型机械、新能源装备的运行数据还是少,学生做相关选题的时候还是不够用。慢慢攒吧,也不用追求大而全,能让每一个上实训的学生,都摸一摸真实的工厂物联数据,知道设计不是对着书本拍脑袋,就够了。
