摘要:工业生产中,机器视觉初检后留存的疑似不良品,长期依赖人工复判,成本高稳定性差。本文结合动力电池顶盖检测的实际工程案例,拆解智能机器视觉复判检测算法系统的设计逻辑、落地要点和踩坑经验,供同行参考。
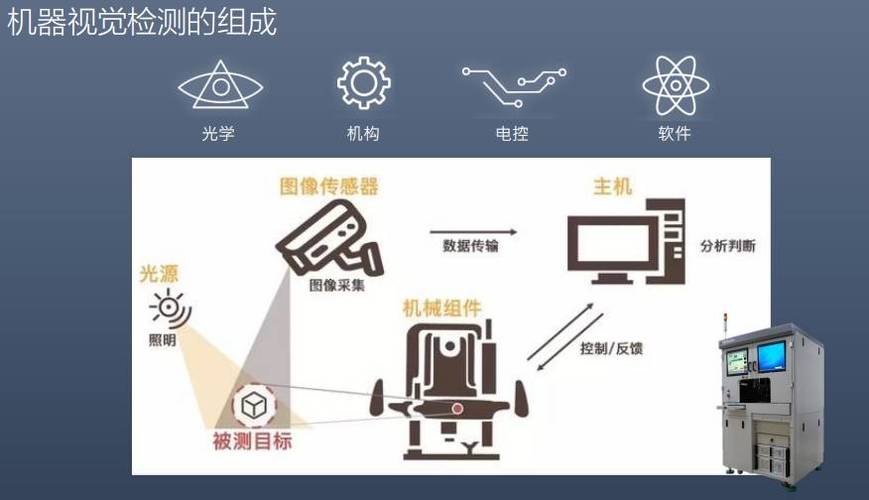
去年给长三角一家汽车零部件供应商做3C动力电池顶盖检测项目,差点栽在初检过检率上。本来初检用的单模板机器视觉,OK率能到92%,剩下8%的疑似不良全得靠人工复判。一条线配两个检验员,每班12小时,干了三个月工人说啥都不干了。眼睛快瞎了。
客户急着降本,我们只能赶紧改方案,做专门的智能机器视觉复判检测算法系统。一开始踩的坑,现在想起来还肉疼。
为什么不能直接把初检算法挪去做复判?
一开始我也想偷懒,直接把初检的ResNet50模型调个分类阈值就上线了。结果一周不到,漏了三个带隐性凹痕的不良件,流到下游组装线,客户直接开了五万罚单。
后来沉下心捋逻辑,才发现根本不是阈值的问题。初检和复判的核心目标完全不一样。初检是快筛,核心是把100%确定的良品放走,宁可错杀一千不能放过一个,所以所有疑似都得捞出来。复判不一样,复判是在捞出的疑似堆里挑真坏,核心要求是极低漏检率,同时尽可能降低误判,不然省不掉人工,方案根本站不住脚。
按GB/T 39116-2020《智能制造 机器视觉检测 性能指标评定方法》的强制要求,量产线复判环节的漏检率必须低于0.01%,误判率不能超过5%。普通初检算法的漏检率通常在0.5%以上,差了两个数量级,根本没法用。
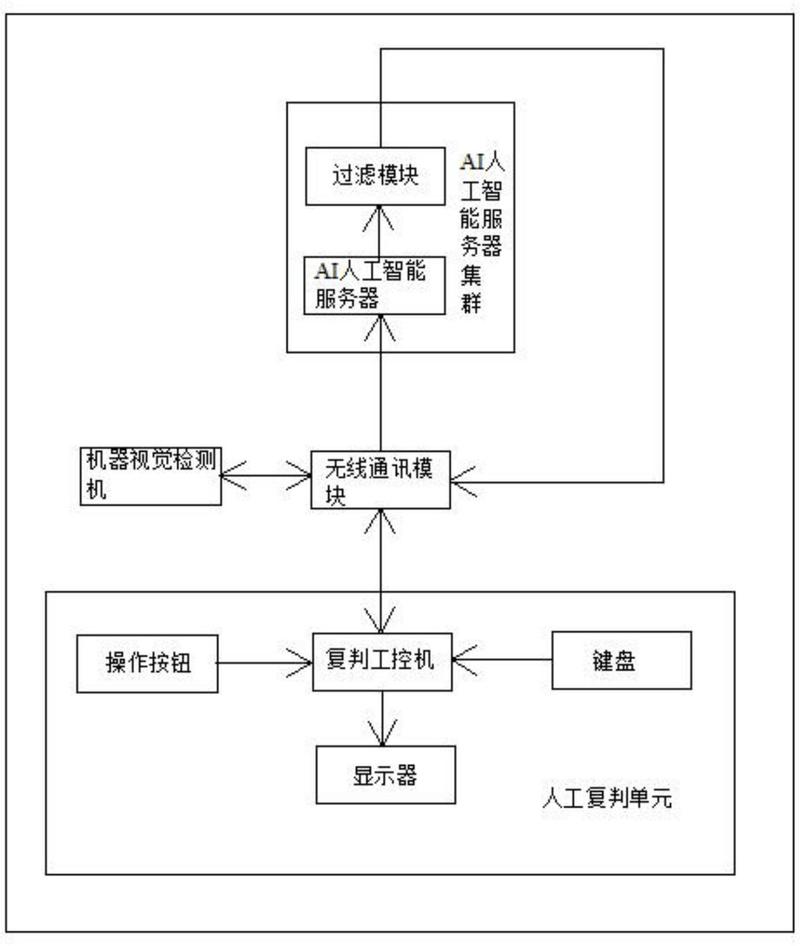
智能机器视觉复判检测算法系统的核心工程设计
我们最终定的架构,是双层级递进推理,说穿了就是先规则过滤大干扰,再用深度学习做细分类,成本和精度刚好平衡。
第一层是规则级快速过滤。你别小看规则,初检出来的疑似项里,至少七成是假的——大多是工件沾了切削液反光、灰尘遮挡、打光不均造成的伪缺陷。这一步根本不用上大模型,直接用形态学开运算做噪声去除,结合灰度直方图阈值分割,对比标准模板的像素偏差,就能直接把70%的伪缺陷过滤掉。说实话,这一步比直接端到端上大模型省钱太多,推理速度快三倍,边缘端跑起来毫无压力。
剩下不到三成的真疑似,送进第二层细分类缺陷检测。这里的选型我踩过坑,一开始跟风上YOLOv8做端到端检测,结果对0.05mm以下的微小凹痕,漏检率一直降不下去。后来换成改进后的Faster R-CNN加特征金字塔FPN结构,问题直接解决了。我们做的动力电池顶盖,最小不良凹痕只有0.02mm,YOLOv8的多次下采样会直接把微小缺陷特征吞掉,Faster R-CNN的双阶段检测,加上FPN多尺度特征融合,能把不同尺寸的缺陷特征都保留下来。
我们实际调参后,输入图像分辨率是2448*2048,FPN下采样倍率设为[2,4,8,16],正样本IoU阈值0.3,分类置信度阈值0.8,最终漏检率稳定在0.008%,误判率2.7%,完全满足国标的要求。
还有数据集的坑必须提。复判任务最头疼的就是样本不平衡,真实不良太少了,我们跑了一个月,才采集到1200张真实不良样本,根本不够训练。最后用DCGAN做缺陷生成,把真实样本扩增到12000张,还特意在生成的时候加了真实生产场景的干扰——打光不均、切削液残留、微小灰尘,模拟实际工况。不过话说回来,生成样本也不能全信,我当时带着实习生一张一张筛,筛了整整一周,差点吐了…但筛完之后,模型泛化性直接提了15%,值。
工程落地的选型权衡和常见踩坑
算力选型,很多客户上来就说要省钱,问能不能用Jetson Nano跑。说实话,每分钟20件以内的小批量生产,没问题。要是每分钟60件以上的量产线,老老实实上Jetson Orin NX。我们实测过,Nano跑完整套双层级推理,单帧要180ms,卡不住生产线节拍,Orin NX只需要32ms,刚好留够余裕。要是预算够,上云端推理也可以,但一定要做本地缓存,防止断网停工,这个是基本操作,不多说。
别信算法能解决所有问题。复判对打光的要求比初检高太多,初检只要抓出疑似就行,复判要精准提取缺陷特征,打光稍有变化,误判率就飙升。我们之前换过一个同型号的打光灯,没重新校准阈值,误判率直接从3%跳到11%,整个项目组折腾了三天才调好。所以一定要加每日自动校准机制,每天开工前自动拍十张带标准缺陷的校验块,自动调整分割阈值和置信度,这点小事能省掉运维一半的工作量。
还有一个坑,就是别过度追求全AI。很多方案商吹什么无规则全AI复判,我见过好几个项目上线就拉胯,实际生产里的干扰千奇百怪,规则过滤能解决八成的简单问题,剩下的交给AI,成本低还稳定。
现在这套系统在客户那边跑了快一年,原来两个全职复判工人,现在只要每周抽两个小时做抽检验证就行,人工成本降了90%,漏检率还比人工复判低一半多。
做工业视觉,其实就是这么回事,适合场景的,才是最好的。对吧?
