上个月帮车间的小兄弟改风机散热的CFD报告,他算出来的流阻比实测值高了42%——翻到网格那页我直接气笑了。
很多工程师觉得CFD是”高端玄学”,要么是算出来的结果和实测差十万八千里,要么是花了一周算出来的云图连给老板汇报都拿不出手。我们不讲复杂的N-S方程推导,只聊在机械散热、流体输送设计里踩过的实坑,给正在做仿真的同行提个醒。
别上来就堆算力,先搞清楚你的网格到底在算什么
太多人刚打开仿真软件,第一反应是点”自动生成网格”,把全局单元尺寸拉到默认值,觉得只要网格数量够多,结果就准。
扯。
我们做水冷板设计的时候,一开始图省事用全局四面体网格,算出来的流道90度拐角处的换热系数比实验台测的值低了30%。当时百思不得其解,直到把拐角局部放大看——那个位置的网格单元是歪的,连流道的真实边界都没贴合,网格尺寸比拐角的曲率半径还大,这相当于你给一个斜着放的杯子拍了张正视图,连形状都错了,算出来的流量、压损能对才怪。
后来我们把流道近壁面做了5层边界层加密,把近壁面y+值控制在湍流模型要求的范围内,拐角区域用非结构化六面体核心网格做局部加密,同样的计算域,网格数量只比之前多了40%,结果和实验值的误差直接缩到4%以内。
真的,别信什么”自动网格足够应付日常设计”的鬼话。你得先想清楚你要算什么:如果是算近壁面的换热,边界层网格的高度、层数、拉伸比,每一个参数都要对着壁面函数的适用范围调;如果是算叶尖的涡流,叶尖间隙区域的网格密度,至少要达到间隙尺寸的1/10,不然涡流还没形成就被网格耗散没了。
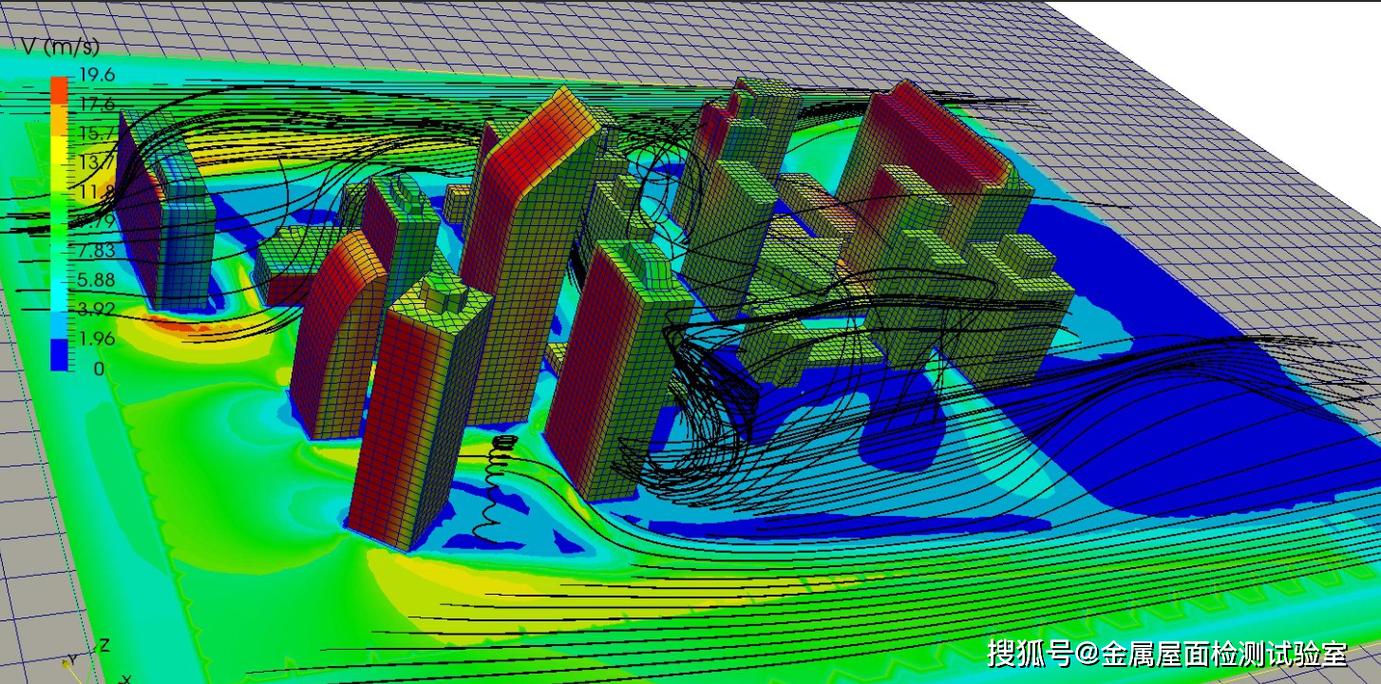
湍流模型选不对,再贵的工作站都是白搭
我见过至少七成的新手,做CFD的时候湍流模型直接锁死默认的标准k-epsilon,从来不会根据流动场景调整。
这模型对啥场景好使?对那种没有强分离、流动方向稳定的管内充分发展流,确实算得快,结果也稳。但你要是拿它算有大角度分离的蜗壳流、汽车后视镜的尾迹、风机叶片的失速工况,那结果能给你偏到姥姥家去。
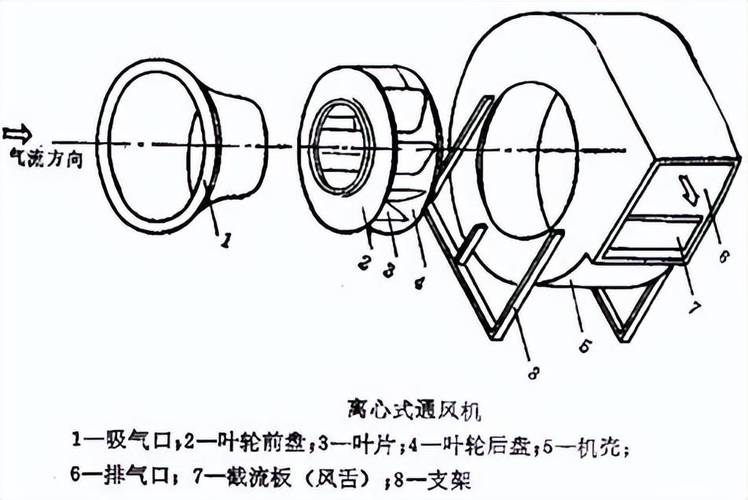
去年做某款离心风机的性能校核,一开始用标准k-epsilon算,出来的全压比实测值低了18%,当时还以为是网格不够密,把网格翻了一倍,结果误差还是16%。后来换了SST k-omega模型,把近壁面的y+值压到1以内,不用壁面函数直接积分到壁面,结果算出来的全压和实测值的差直接降到3%,刚好满足GB/T 1236-2017 工业通风机 用标准化风道性能试验里对仿真校核的精度要求。
不过话说回来,也不是越复杂的模型越好。你要是算个简单的直管段流阻,非要上LES大涡模拟,那算一个工况的时间够你把整个管网的所有设计方案都测完了,纯纯浪费算力。选型的核心从来不是”用了最高级的模型”,而是”模型的假设和你实际的流动场景能不能对上”。
别光看云图好看,你的结果过了网格无关性验证吗
现在太多仿真报告,翻开来全是漂漂亮亮的彩色云图,红的蓝的渐变做得比广告图还好看,一问核心参数的验证过程,啥都没有。
我上次审一个车载空调出风口的设计报告,他们用80万网格算出来的出风均匀度是89%,说这个结果完全满足设计要求。我让他们把网格加密到220万,再算一次,结果均匀度直接跳到94%。这差的5%是什么概念?是吹出来的风对着人脖子吹,还是对着挡风玻璃吹的区别,能随便拿个没验证的结果就定设计方案吗?
网格无关性验证从来不是走流程的形式主义。简单说,就是你得在你最关心的核心参数(比如风机全压、水冷板最大热阻、出风口吹风角度)上,逐步加密网格,直到参数的变化率小于2%,才能说明你现在的结果不会因为网格的疏密出现大的偏差。很多人嫌麻烦,觉得网格数越多越准,其实根本不是——你加密的位置如果离你关心的核心参数区域十万八千里,哪怕把网格加到1000万,结果还是飘的。
还有个容易被忽略的坑:边界条件别拍脑袋填。之前见过一个做工业除尘器的小兄弟,仿真的时候把进口设成了均匀速度进口,出口设成了标准大气压,算出来的除尘效率比实测高了20%。到现场一摸才知道,除尘器的进口前面接了3米长的弯头,气流根本不是均匀的,有明显的旋流,他直接把进口设成均匀速度,等于把进口的旋流损失全给抹了,结果能准才怪。
CFD这东西,从来不是点一下”计算”就出结果的黑箱。你对流动的物理本质理解多少,对工艺的实际偏差考虑多少,结果就给你多少回报。
我见过不少刚入行的小兄弟,花几十万买了软件授权,却连壁面函数的适用范围都没搞清楚,算出来的东西自己都不敢信,还天天抱怨仿真不准。
多去现场摸一摸实物。
多和实验数据对一对。
真的,比啥都强。
