最近两年接触了近20个工业AI落地项目,见过太多花了大价钱却用不起来的烂尾系统,也摸出了几条能让算法真正在车间跑起来的实路。没有虚头巴脑的概念,全是踩过坑攒出来的经验。
别拿互联网AI的套路硬套工业现场
上周跟车间的王工蹲在冲压线旁边测振动数据,他指着屏幕上飘的一堆监测曲线骂了半小时——花了两百多万上的所谓工业AI预测性维护系统,报警误报率快到40%,连个固定螺栓松了都识别不出来。
差一点。
差的不是模型精度,是对现场的敬畏。
互联网AI的逻辑是啥?找海量公开数据集,调参刷榜,模型越复杂越好,参数越多越牛。但工业现场的数据,从采集环节就带着一身“毛病”:旁边高频焊机的电磁干扰会让振动传感器基线漂2个g,不同批次的铸坯硬度差15HB会让切削力曲线整体偏移,甚至夏天车间温度升到42度的时候,液压站的压力波动都比冬天大30%。
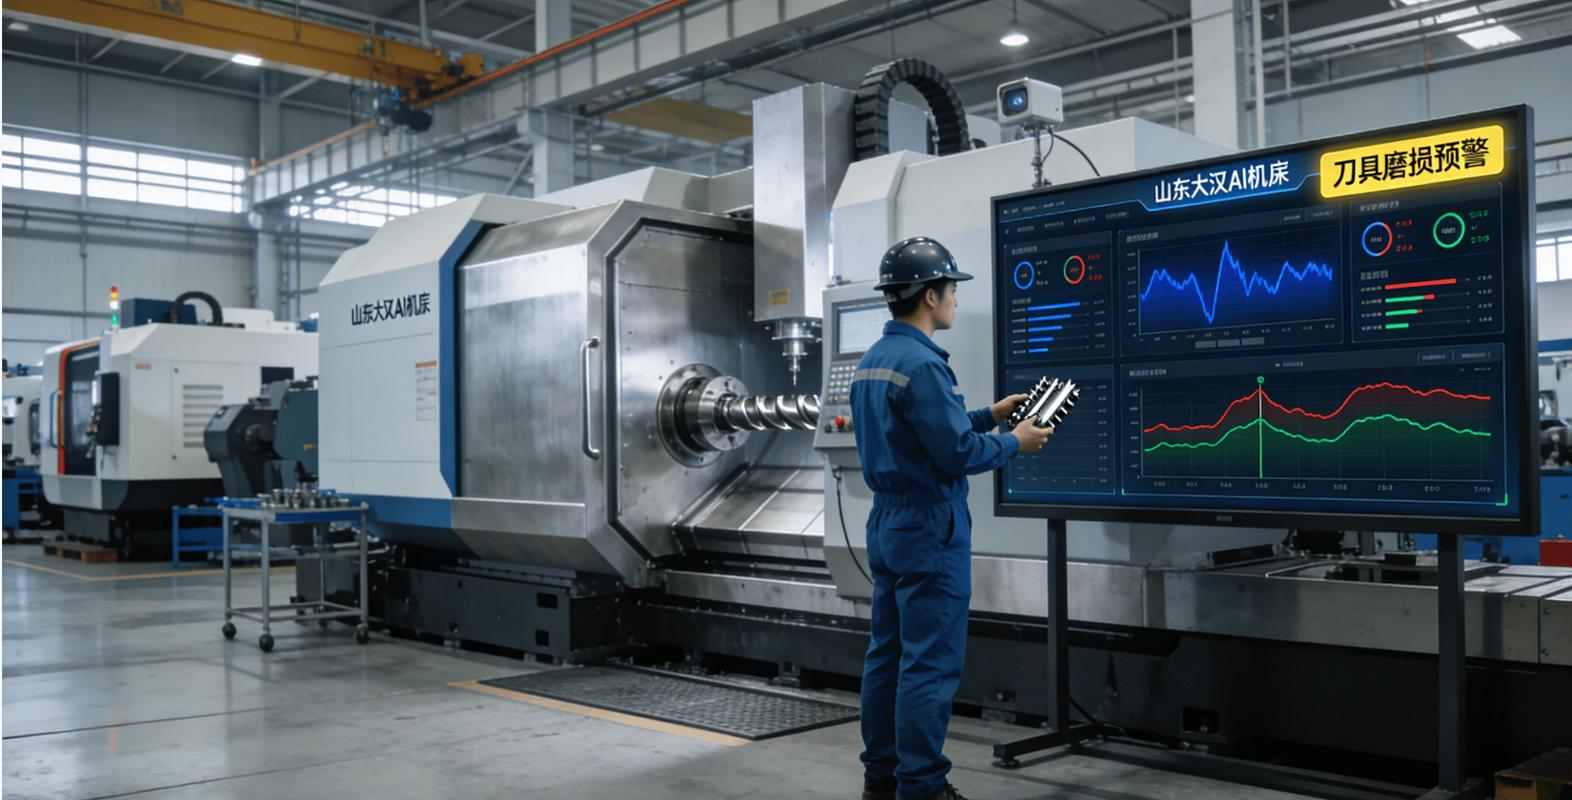
之前做数控刀具磨损预测项目,实验室里用公开数据集测出来准确率97%,拉到现场一测,模型直接把正常磨损当成崩刀报警,整线停了15分钟,算上误工和原料损失小十万。后来蹲在车间测了三天才发现,传感器的安装位置错了——本来应该贴在轴承座的刚性连接面上,结果供应商为了省事,用双面胶粘在了薄薄的机床外钣金上,测出来的信号全是钣金共振和行车路过的干扰,这种数据喂给算法,就算是GPT来了也识别不出来啥故障。
说真的,我见过太多供应商拿着通用CNN模型就敢来投标,连现场的电磁环境测试报告都不看,这不是纯纯骗钱吗!
那些被你忽略的工程约束,才是算法的核心边界
很多人训练工业AI模型的时候,第一反应是要把整体准确率拉到最高,mAP冲到0.9以上才算合格。这思路在工业场景纯纯是错的。
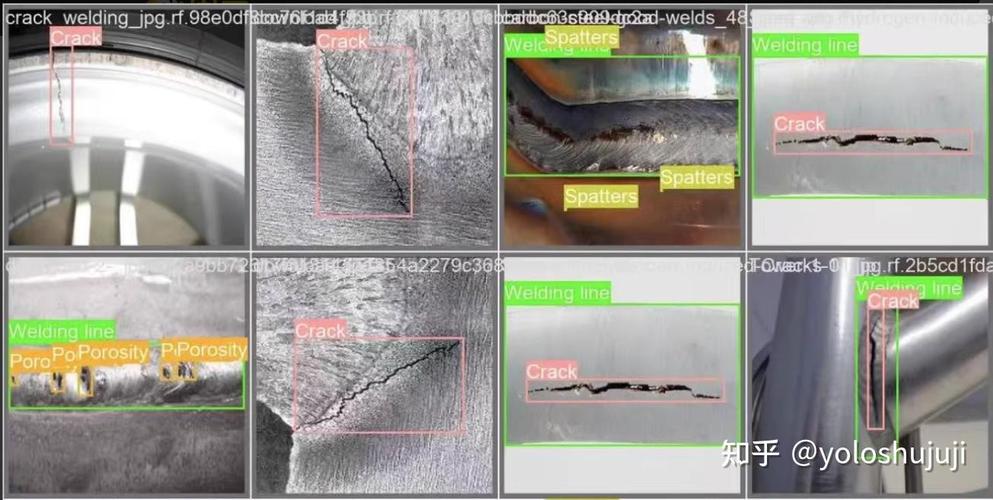
按照GB/T 33000-2016《企业安全生产标准化基本规范》的要求,机械加工场景的缺陷检测,漏报率必须为0——你漏过一个带裂纹的零件流到总装线,最后出了整车事故,损失是百万级的。而误报的成本呢?无非是把零件拿下来人工复检一遍,单个零件的复检成本撑死5块钱,对吧?
所以我们做焊缝缺陷检测模型的时候,根本不用通用的交叉熵损失函数,自己改了权重:Loss = λ1 * L_miss + λ2 * L_false,其中λ1直接设成λ2的120倍。说白了就是,算法宁愿多报120个假缺陷,也不能放过一个真的裂纹。之前有个项目,一开始为了冲mAP,把小气孔都标成合格,结果探伤的时候检出内部裂纹,整批1200个零件全部返厂,赔了快二十万。
还有个最容易踩的坑:数据集拆分。很多人图省事,把所有数据随机按7:3拆分训练集和测试集,测出来准确率99%就觉得稳了。这在工业场景完全是自欺欺人——同一台设备连续3天采的振动数据,分布几乎是一模一样的,随机拆分的话,训练集和测试集的数据高度重合,测出来的数全是虚的。正确的拆分方式必须按时间维度切:比如前20天的数据用来训练,后5天完全没见过的数据用来测试,泛化能力到底行不行,一测就露馅。我上次见个刚毕业的算法工程师,拆分数据集的时候手快随机抽,被现场的老技师追着骂了三层楼——你这测出来的数都是虚的,真上了线出问题谁担?
小模型才是工业现场的香饽饽
现在行业里总有人吹,要上千亿参数的大模型做工业质检,做设备运维。我每次听到都想笑。
车间里的边缘计算网关,算力才1TOPS,内存2G,你整个10亿参数的模型,光加载就要10秒,还谈什么实时监测?夏天车间温度40度,灰尘满天飞,交换机都经常掉包,你整个大模型靠什么稳定跑?靠爱吗?
我们去年给某水泵厂做泵体泄漏监测的算法,一开始用ResNet50,模型大小90M,边缘网关跑起来延迟300ms,离要求的100ms以内的响应标准差了一大截。后来拉着厂里做了20年水泵设计的老工程师聊了一下午,才发现泄漏产生的振动频率是固定的——就集中在2kHz到5kHz的频段,其他频段的信号全是泵转频的固有振动、电机的电磁噪声,根本和泄漏没关系。
我们干脆先在信号采集端加了个带通滤波器,把无关的频段全滤掉,然后把模型换成只有3层的MLP分类器,最后整个模型大小才200K,跑起来延迟降到12ms,准确率还比原来的ResNet高了3个百分点。
这里要敲个重点:工业AI算法的本质,是把机械工程师几十年积累的工艺常识,翻译成算法能读懂的特征,而不是让算法自己在海量噪声里瞎找规律。你对工艺的理解越深,需要的模型复杂度就越低,跑起来就越稳。
上个月我们给那条冲压线重新调的算法上线,现在误报率降到1.8%,上周王工给我发微信,说终于不用天天盯着屏幕处理假报警了。
其实哪有什么高大上的工业AI啊。
无非是把现场的每一个噪声源、每一个工艺波动、每一次报警的代价都算清楚,再把模型调到刚好适配这个场景的大小而已。
别整那些花里胡哨的。能在车间里稳定跑三年不出幺蛾子的算法,才是真的好算法。
