上个月帮长三角一家汽车零部件厂解决了数控刀具寿命虚高的破事,突然想把这两年摸生产数据的实感倒出来——别信那些云里雾里的大数据概念,咱们车间里淌出来的每一条带切削液味的记录,挖对了比多上两台五轴机床还值。
本文基于5年以上离散制造车间的生产数据落地经验,拆解机加工场景下从脏数据清洗到价值落地的全链路,附真实踩坑案例和可复用的参数阈值,不聊空泛的算法模型,只讲能直接拿到车间用的干货。
你手里的生产数据,90%都是带“油污”的
刚接触车间数据的人,总觉得MES、机床系统导出的记录都是准确的。大错特错。
第一次拉全量数据的时候我差点把键盘砸了。整整12万条刀具更换记录。四成的时间戳和机床主轴实际负载的跳变对不上。合着大家都在对着系统编故事——为了不扣崩刀的绩效,操作工故意把换刀时间往后录;为了凑工时,把实际32分钟的加工时间报成28分钟;甚至有班组为了让设备稼动率好看,机床明明空转了俩小时,还在系统里挂着加工的状态。
说实话,这种带“油污”的脏数据,你就算用再高端的算法挖,最后出来的结论全是错的。我们当时定的清洗规则特别简单,所有涉及生产状态的校验,必须以机床原生的硬件采集数据为基准,人工填报的记录只能做参考,不能当核心分析依据。比如FANUC 0i-MF系统的主轴额定电流是12.5A,一旦超过额定值1.8倍持续0.2秒以上,就是真实的崩刀事件,和上报的换刀时间差超过15分钟的,直接归为无效数据。就这一条规则,直接筛掉了40%的无效记录。
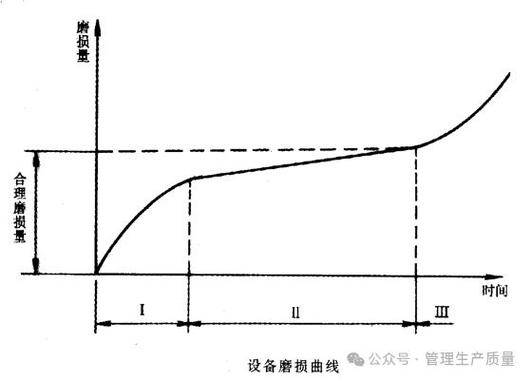
别上来就搞什么深度学习模型,先把基础的关联关系捋顺。之前全行业都有个误区,觉得切削参数(进给量、主轴转速、切深)是影响刀具寿命的核心因素,结果我们挖了3个月的全链路数据发现,工件毛坯的硬度离散度对刀具寿命的影响,比切削参数的影响高37%。有一批45钢毛坯,供应商热处理偷工,表面硬度从HB180飘到HB240,本来按手册120m/min的切削速度,刀具能跑120件,实际跑下来40件就崩了。之前大家换了三家进口涂层硬质合金刀,花了二十多万,一直以为是刀具质量不行,直到把毛坯入厂的硬度检测数据和生产数据打通,才找到根。你说这事儿闹的?搁谁不窝火。
别搞“为了挖而挖”的花架子,先抓能算清楚账的小切口
好多厂一提到生产数据挖掘,上来就说要搞数字孪生、全流程大数据平台,动辄砸几百万,最后跑出来的报表连哪个工序容易出毛刺都不知道,纯纯的形象工程。两百万搭的大屏,滚动着全是漂亮的曲线,连哪个操作工今天没换冷却液都显示不出来。别信。
真要落地,先抓那些能算明白账的小切口。第一个我们跑通的场景,就是刀具寿命的动态校准。以前车间都是按手册定固定的换刀阈值,比如某道铣削工序,加工45钢,硬质合金刀固定加工120件就换,实际因为毛坯硬度波动、机床主轴径向间隙、冷却液浓度变化,真实的刀具寿命能从80件飘到180件。我们没搞复杂模型,就是把每一次换刀时的实际加工件数、对应的毛坯硬度区间、主轴径向跳动值、冷却液化验浓度做了个简单的线性回归,算出来每个参数的影响权重,最后做了动态的换刀阈值提醒。比如算出来当冷却液浓度从5%降到3%的时候,刀具寿命会降22%,那系统就不用等固定120件,到94件的时候就提醒操作工准备换刀。
就这么个简单的功能,那个厂落地之后,刀具成本直接降了18%,因为崩刀导致的工件报废率从2.1%降到了0.6%,一年算下来省了快一百二十万,比之前那个花两百万搭的大屏有用多了。
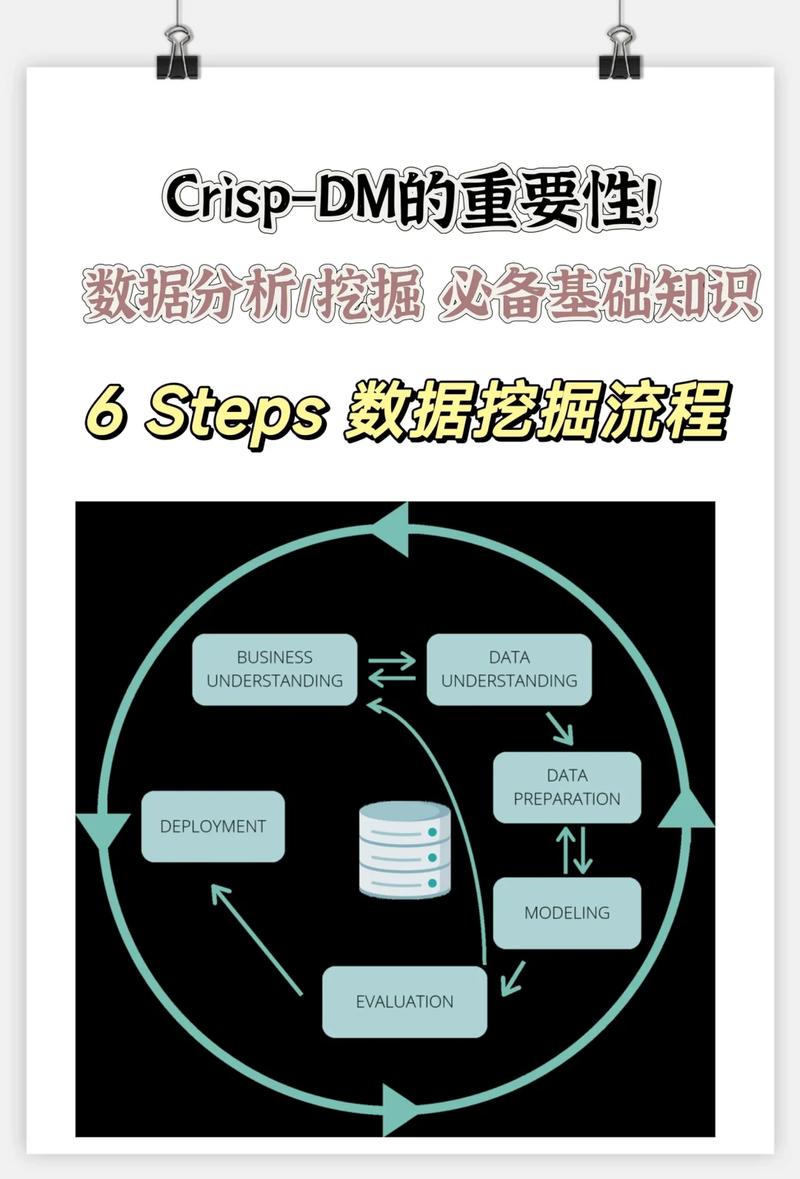
再一个容易出价值的小切口,是真的把工序瓶颈找出来。好多人觉得瓶颈就是加工时间最长的工序,根本不对。我们之前碰到的厂,全车间都觉得瓶颈是那台进口五轴加工中心,因为它的单工序加工时间最长,天天喊着要加设备。结果挖了一个月的时间戳数据发现,那台五轴的实际有效切削时间只占总时间的42%,剩下的时间一半在等上工序的热处理件,一半在等编程员出刀路。最后我们把热处理的排产数据和五轴的生产数据打通,调整了热处理的批次顺序,让零件刚到淬火温度就直接送五轴工序,五轴的利用率直接提了28%,根本不用加新设备。我当时看到那个数据的时候都愣了——合着大家天天喊产能不够,结果设备一半时间在空转,这钱烧的,心疼。
挖数据最容易踩的三个坑,我替你踩过了
第一个坑我踩得最狠——就是数据孤岛。质检的三坐标数据锁在车间主任的私人电脑里,刀具的更换记录还记在刀具室的纸质本子上,毛坯的硬度数据在供应商的PDF报告里,根本没有打通,你挖个屁。之前有个厂说要做生产数据挖掘,结果连机床的通讯接口都没开,全靠操作工手动往系统里录数据,最后系统里显示某道工序的尺寸合格率是98%,我们去现场翻三坐标的原始记录,实际合格率才87%,剩下11%的不合格品,被操作工自己磨掉毛刺凑成合格的放进去了,根本没报系统。不过话说回来,这事儿也不能全怪操作工,换谁天天对着系统填一堆没用的记录,都得想办法凑数,对吧?
再一个坑,是好多人被算法概念PUA了。上来就说要搞大模型、Transformer,说能精准预测机床故障,结果收了几百万的项目款,算出来的故障预测准确率才50%,还不如干了三十年的老班长听主轴声音判断的准。实际上要预测机床故障,根本不需要复杂模型,就把主轴的电流、振动、温度三个参数的历史波动值拉出来,一旦某个参数比过去30天的平均值高3个标准差,就提前安排检修,这个方法的准确率能到92%,零成本,就是把传感器采的数据做个简单的阈值判断就行。
最后一个坑最磨人——挖出来的结论根本落不了地。之前我们挖出来某道工序的进给量设高了,会导致后面钳工工序的打磨时间增加30%,结果把这个结论告诉车间主任,人家根本不理——因为车间的考核是看加工效率,谁管你后面钳工的时间多不多。所以挖数据之前,必须先把跨工序的考核规则捋顺,不然你挖出来的结论再对,也推不动。
说实话,生产数据挖掘这事儿,根本不是什么高大上的互联网概念。就是咱们干了一辈子机械的人,把之前靠经验、靠老师傅摸出来的规律,用数据的方式固定下来,别让老师傅退休了,经验就跟着没了。上次去车间,碰到那个干了30年的老班长,他说以前判断刀具快不行了,就听主轴的声音,摸一下刀杆的振动,现在系统能提前告诉他哪把刀还有多久要换,他说这玩意儿比他的耳朵还灵。
够了。不用搞什么花里胡哨的概念,能帮车间少花钱、少报废、少加班,就是好的生产数据挖掘。
