很多工厂在搭建算力系统的时候,习惯照搬互联网机房的调度逻辑,最后要么算力利用率上不去,要么高峰期任务延迟导致产线停摆。过去3年我们在17家离散制造工厂摸爬滚打,踩过算力宕机导致停线的坑,算过高温下GPU衰减的系数,调过几十版优先级规则,把这些落地里的硬经验整理出来,给正在做车间算力调度的同行做个参考。
车间侧的算力负载,从来不是均匀排队的任务流
很多人对工厂算力负载的认知,还停留在“所有任务按提交顺序排队,谁先到谁先跑”的阶段。
这完全是脱离现场的想象。
我们去年在苏州某精密机加工车间做基线测试的时候,连续录了两周的节点负载数据,发现工作日的负载曲线跟写字楼的办公系统完全是两个极端:每天上午9点到10点半,下午1点半到3点,所有工位的视觉检测、刀具磨损监测、尺寸在线测量的实时推理任务会同时启动,单台边缘节点的GPU占用率会在3分钟内从15%飙到80%,等过了这个高峰,又会掉到20%以下。更有意思的是,这些实时任务的延迟要求卡得极严——按照行业通用的检测精度标准,视觉缺陷识别的单帧推理延迟不能超过120ms,一旦超过这个阈值,按照GB/T 2828.1-2012的抽样检验规则,漏检率会直接突破0.2%的合格线,后续的质量追溯成本会翻三倍。
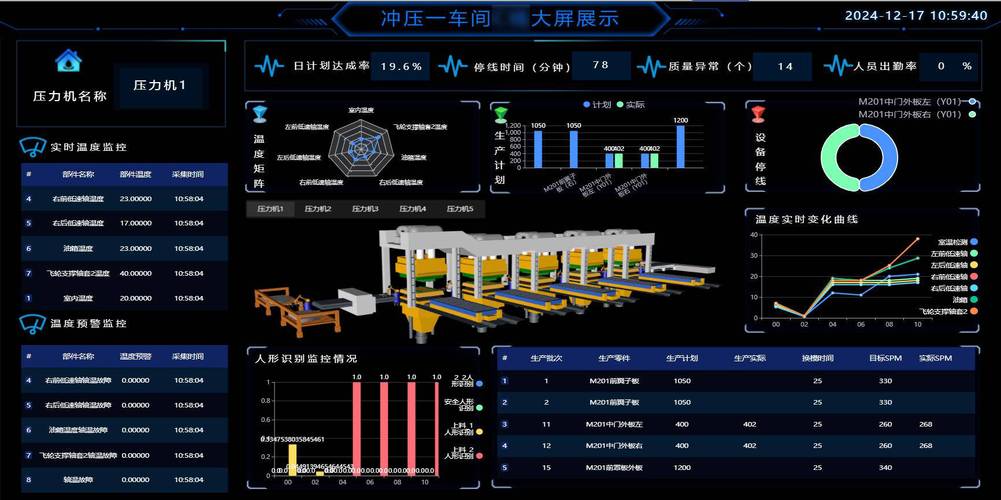
最早我们做第一版调度规则的时候,图省事直接抄了云平台的负载均衡逻辑,把所有实时检测任务平均分摊到车间的8台边缘服务器上,没加任何优先级判断。结果上线刚到第二周,周二上午9点17分,3号冲压工位的检测任务直接卡了320ms,把一个带有0.5mm深度裂纹的冲压件放过了检测工位,流到总装线才被发现。
冷汗瞬间就下来了。
停线排查了两个小时才找到原因:当时给3号工位分配任务的那台边缘服务器,前一天被工艺组提交了一个模具型面拓扑优化的离线仿真任务,本来预估跑2小时就能结束,结果工艺工程师为了算得更准,把网格密度从2mm提到了0.5mm,任务硬生生跑了8个小时,刚好卡在早高峰的检测时段还没结束,把节点的CPU和GPU资源吃走了40%,直接挤得实时检测任务延迟超标。
说实话,那天之后我们就把之前写的调度规则全推翻了——车间里的两类负载,根本不是同一级别的存在。
把算力调度的优先级表,跟生产排程绑在一根线上
很多IT团队做算力调度的时候,习惯自己拍脑袋定优先级,结果跟生产现场的节奏完全脱节。
我们现在做规则设计的时候,从来不是先看算力利用率,而是先拉MES系统的未来3天生产排程表,把所有需要用到算力的任务,按照生产影响程度划成不同档位。
最优先级的是实时生产类任务,包括视觉缺陷检测、设备振动异常监测、PLC运行数据的实时推理,这类任务只要延迟超过阈值,就可能直接导致停线或者质量流出。这类任务的资源预留比例,必须占到对应边缘节点总算力的70%,而且设置硬资源锁,不管其他任务优先级多高,都不能挤占这部分预留资源。
为什么是70%而不是60%?
我们之前在南方三个无恒温空调的车间测过,夏季中午车间配电间的温度能到39度,GPU核心温度冲到85度的时候,算力会自动降频12%-20%,如果当初按60%的线留预留,高温天实际能用的实时算力可能就剩48%,根本扛不住高峰期的负载。
再往下一档是准实时类任务,比如数字孪生的产线状态推演、刀具寿命的动态预测,这类任务的延迟要求在秒级,就算卡个几秒钟,也不会直接影响生产。这类任务只能用实时负载预留完之后剩下的30%算力,而且要设置硬上限,最多能占剩余算力的70%,绝对不能把节点占满。
剩下的就是离线类任务,比如工艺参数的全局优化、检测模型的离线训练、历史生产数据的统计分析,这类任务可以在生产低峰时段(比如凌晨12点到早上7点)运行,就算临时被打断,也可以随时暂停,等高峰过了再接着跑。
之前碰到过一个踩坑的客户,为了把算力利用率拉到90%以上,把实时检测任务跟离线的模型训练任务跑在同一个节点上,调度系统没给实时任务留硬预留,结果某次训练任务因为梯度计算量太大,突然吃满了85%的GPU资源,导致旁边的检测任务连续12秒没有返回结果,漏了3个表面划痕的零件,最后被下游客户退了两批货,损失了快三十万。
不过话说回来,也不能为了保实时任务,把离线任务的算力压得太死。我们现在会跟工艺组约好,所有需要跑的离线任务,必须提前24小时在调度系统里登记,系统会自动结合未来24小时的生产排程,算出来哪个时段哪个节点有空闲算力,再把离线任务排进去,根本不需要人手动分配。
别迷信“全集中调度”,车间里的局部自治比啥都靠谱
现在很多厂商推全厂级的算力池方案,说要把所有车间的边缘算力都集中到中心机房统一调度,实现“算力随需流动”。
听着很美。
但真到车间现场,这套逻辑根本站不住脚。
车间里的网络环境,跟写字楼的机房差远了。焊枪的电磁干扰、天车运行时的信号波动、甚至夏天雷电天气导致的交换机端口闪断,都是家常便饭。之前我们帮一个客户测过三个月的网络稳定性,车间到中心机房的1000M光纤,平均每个月会出现3-5次每次2-5秒的闪断。如果真的把所有实时任务都交给中心调度系统来派单,一旦网络断了,所有工位的检测任务直接卡壳,那停线损失谁来担?
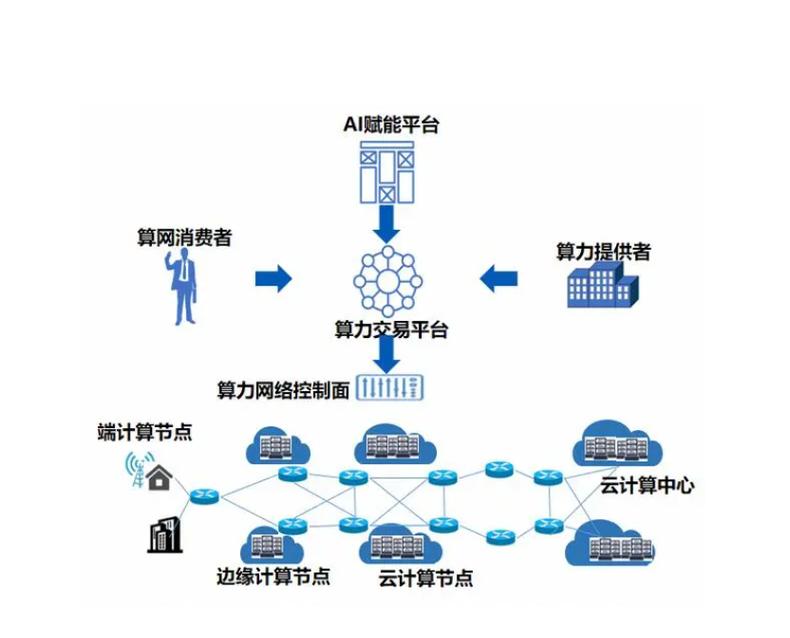
我们现在做的调度架构,从来不是把所有权限都收到中心,而是做“两层调度”:最底层是每个边缘节点组的局部自治调度,每个节点组负责3-5个相邻工位的实时任务,不管跟中心的连接通不通,节点组自己就能完成实时任务的分配、优先级判断和故障切换,根本不需要等中心的指令。中心调度系统的作用,就是在生产低峰的时候,把各个节点组剩下的零散算力攒起来,跑全厂级的大任务,比如整个车间的数字孪生推演、全产线的工艺参数优化。
之前跟某互联网大厂的架构师聊,对方说我们这种局部自治的模式“算力利用率太低”,达不到他说的“95%以上的池化利用率”。我当时没好意思说——你要是能保证车间的网络跟你家机房一样稳定,我也愿意做全集中调度。但现实是,车间里的所有技术,首先要保证的是不影响生产,其次才谈得上效率。
做了这么多工厂的算力项目,最大的感受是,工厂的算力调度从来不是一个纯IT的技术问题。你要是没在车间里蹲过半个月,没见过焊枪打出来的火花溅到交换机端口上的场景,没碰到过夏天高温导致服务器降频的破事,没跟质量部的人一起追过漏检的零件,写出来的调度方案,落地的时候一定会踩坑。
毕竟,算力利用率再高,只要因为调度不当导致一次停线,算下来的损失,可能够你买三排新的服务器。真正靠谱的工厂算力调度,从来不是追求面板上的好看数字,是让实时生产的任务永远跑在最前面,让剩下的算力不被浪费,就算出了点小问题,也不会影响生产线的正常运转。
