车间里那台永远在等料的CNC

干了十几年机械加工,我见过太多这样的场景:一台五轴加工中心停机了,操作工在那儿刷手机,问就是“等毛坯”。可你再往上游看,那批毛坯明明三天前就入库了。调度员一脸无辜——“系统里没排上”。这事儿怪谁?说到底是排产逻辑还停留在Excel时代。
智能生产调度这个词,圈子里喊了至少七八年了。但说实话,真能跑通的车间,比例低得可怜。不是算法不行,是太多项目死在了“最后一公里”——现场那台机床的换刀时间根本不是理论值,叉车司机中午还要吃饭,质检一插单整条线就得重排。
我是做机械设计出身的,后来被逼着啃了运筹学,现在回头看,调度这事儿的本质跟结构设计没区别——都是在约束条件下找最优解。只不过一个是应力约束,一个是节拍约束。
先用数学语言把“车间”说清楚
别急着上AI,先把模型建对。
车间调度最经典的表述是作业车间调度问题(Job Shop Scheduling Problem,JSSP),三参数表示法 n/m/G/Cmax,n个工件、m台机器、G代表一般型、目标是最小化最大完工时间。这个表述在1960年代就被Giffler和Thompson定义清楚了,Ackoff那本《Introduction to Operations Research》里写得很明白。理论界后来又在它身上长出了一堆变体:柔性作业车间(FJSP)、考虑机器可用性约束的、带批处理的……
但工厂里的调度,数学建模只是第一步。你拿真实工单去套JSSP,会发现几个事根本没法写进教科书:
一是换型时间跟序列强相关。比如注塑机上换模具,从A模换到B模,和从C模换到B模,时间能差出40%。这个在学术模型里叫序列相关准备时间(Sequence-Dependent Setup Time),你直接按固定值建模,排出来的计划执行时基本全废。二是并行机不等于同速机器。两台型号一样的加工中心,主轴用了五年和用了两年的,实际切削进给率差10%很常见。三是有共享资源,比如行车、刀具库、检测工位,这些在经典JSSP里根本不存在,但在车间里它们就是瓶颈。
一个经常被忽略的点:加工时间不确定性的处理方式,决定了你用哪种调度范式。如果你按确定性模型排,实际执行时遇到刀具崩刃、材料硬度超差,整个计划就崩了。这时候需要的是反应式调度(Reactive Scheduling)——出了问题动态修,而不是试图一开始就把所有扰动预测进去。
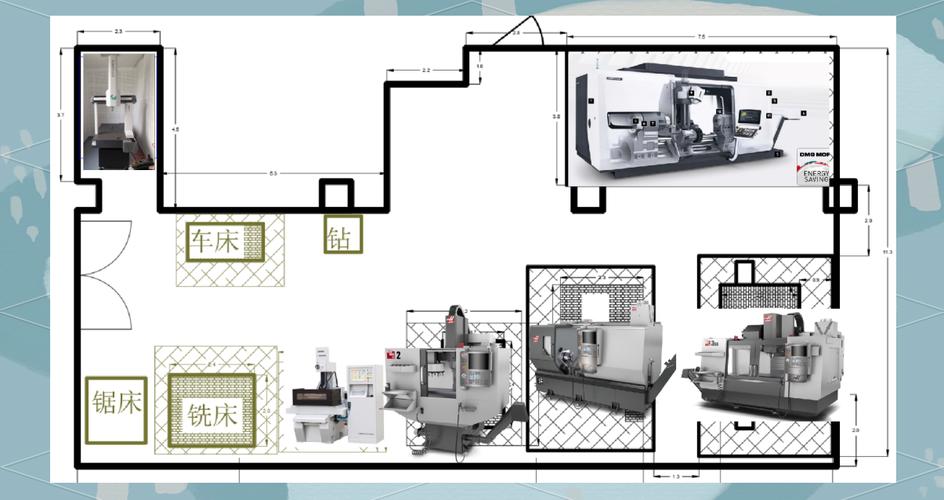
从启发式规则到元启发式,怎么选?

说人话就是:你是要快速得到一个“还行”的解,还是愿意多花点时间找一个“很好”的解。
早期车间用的都是优先级规则,SPT最短加工时间优先、EDD最早交期优先、CR关键比……这些规则计算量极小,毫秒级就能排出来,MES系统里随手就能嵌。我见过一个轴承磨加工车间,就靠SPT加EDD混合规则,把平均流程时间压了22%。别看不起简单规则,在很多单件小批量场景下,它比那些花哨的算法还稳。
但规则调度有个硬伤:短视。它只看眼前这一步,不关心后面会不会堵。遇到复杂的工艺路线和共享资源约束,单纯靠规则很容易排成死锁——所有工件都在等同一台热处理炉,而热处理炉前面又堆满了等它的活儿。
这就得搬出元启发式算法了。遗传算法(GA)、粒子群(PSO)、模拟退火(SA)、禁忌搜索(TS),四大金刚。说几个我踩过的坑:
遗传算法编码方式选错,全盘皆输。早期我做过一个项目,用基于工序的编码(Operation-Based Encoding),交叉操作后经常产生非法解,还得额外写修复逻辑。后来改用基于工件的编码加解码器,才稳定下来。GA的种群规模、交叉概率、变异概率这几个参数,没有万能值——我之前调过一组参数在半导体封装线上效果极好,换到汽车冲压线就完全不行。参数必须跟着问题结构走。
模拟退火在中小规模问题上表现很稳,但降温策略设计不好就退化成随机搜索。常用的是几何降温 T(k+1) = αT(k),α取0.85到0.98之间比较常见。但要注意,初始温度得够高,否则解空间探索不充分。这东西的原理最早来自Metropolis那个著名的1953年论文,Kirlpatrick在1983年把它引入组合优化,现在成了调度领域的标配工具。
还有一个问题几乎所有人都会遇到:目标函数怎么定义。你只优化Cmax(最大完工时间),排出来的计划可能交期一堆超期。你优化总拖期,又可能导致设备利用率一塌糊涂。实际我们常用加权的多目标:F = w1 × Cmax + w2 × ΣTardiness + w3 × ΣChangeoverTime。权重怎么定?靠经验——这句大概是所有工程师最坦诚的实话了。
实时调度和数字孪生:不是买套软件就能落地
很多企业花大价钱上了APS系统,结果发现用不起来。问题往往不在算法,而在数据链路。
一个实时调度的闭环,数据得从三处来:PLC里的设备状态、MES里的工单进度、以及人工报工。这三处的数据质量直接影响调度结果。我见过一个项目,设备状态延迟了整整8分钟才传到调度引擎里——因为MES和PLC之间的OPC UA通信写错了轮询周期。8分钟在离散制造里,孔都快钻完了。所以数据采集的刷新频率和调度引擎的决策周期必须匹配,一般来说调度周期至少得比关键设备的平均加工时间短一个数量级。
数字孪生这块,实际上很多项目做成了“数字大屏”。真正的孪生应该是仿真模型和物理系统双向映射,仿真参数跟着实际数据在线校准。比如刀具磨损系数、实际切削进给率、设备故障率这些,得定期用现场数据去迭代。

再聊一个实操问题:插单。这是所有调度系统都必须面对的场景。插单策略本质上是在做局部重调度。我的经验是——不要每次都全局重排,那样计算量太大,而且会让在制品库存波动剧烈。更稳的做法是把重调度范围限定在冲突设备的上下游缓冲区,用增量式方法处理。这跟力学里的子模型技术是一个思路:只对受影响区域做精细分析,远处区域保持原解。
说点结论,其实也不算结论

智能生产调度从来都不是一个纯算法问题,也没法单靠买一套软件就解决。它是算法 + 数据 + 工艺知识三根腿的板凳。缺哪一根都站不住。
我的建议很朴素:如果你在选型阶段,先别去比算法谁先进。先看看这套系统能不能跟你的PLC、MES、WMS打通。再看看它的约束建模能力——能不能处理序列相关换型时间?能不能设置共享资源?不能的话,算法再炫也是空中楼阁。
如果你已经在实施阶段,记住一件事:先用真实数据跑1000次仿真验证,再上线。调度系统出错的代价,可比机床撞刀大多了。车间里每一条计划都是一堆钱堆出来的节奏,别让排产算法毁在没调好的参数上。
