摘要:本文从机械工程师的视角出发,讨论工业数据汇聚在协议适配、时间同步、边缘预处理和数据建模四个层面的实际问题。不堆砌概念,只讲车间里真实发生的坑和选型时该算的账。适合有一定现场经验、正在或即将负责设备数据上云的中级工程师阅读。
上周三凌晨两点,产线MES又断了。不是网络。是汇聚层的时间戳乱了——同一批冲压件,压力曲线的时间戳居然比实际早了4.7秒。质检那边直接炸了锅。我盯着屏幕,心里只有一个念头:这破数据,到底是谁在中间把它揉成了这样?
别急着买网关,先把协议这锅粥搅清楚
干了十几年机械设计,我从来没想过自己会跟OPC UA、Modbus TCP这些词纠缠不清。但现实就是这样。你设计了一套液压站,客户说要把数据传到集团的数据中台。好,问题来了。
车间里的设备,年龄跨度可能超过二十年。一台1998年的西门子S7-300,用的还是Profibus DP;旁边2022年新上的发那科机器人,原生支持OPC UA和MTConnect;再远一点,那台国产注塑机,厂家给你留了个Modbus RTU的串口,寄存器表还是纸质复印件。你要把这些东西汇聚到一起,第一步不是写代码,是搞清楚每一台设备到底能吐出什么格式的数据。
Modbus简单,但坑也深。浮点数用两个16位寄存器拼,字节序有大端小端,字序还有高低字交换。我见过一个项目,压力值一直显示为0.00,查了三天,最后发现是寄存器地址偏移了一位。就这么一位。现场工程师差点把PLC砸了。
OPC UA看起来美好,信息模型自带语义。但很多老设备的OPC UA服务器是后来加的,变量命名一塌糊涂。NodeID是一串看不懂的字符串,BrowseName写的是“Tag_001”。你问设备厂家要变量表,对方发来一个Excel,里面三百个点,备注栏全是空白。

我的建议是:在协议转换层做一次彻底的盘点,把每个数据点的物理含义、单位、量程、采样周期、精度全部落成表格。别嫌麻烦。这张表后面会救你很多次。
时间戳不统一,后面的分析全是白费
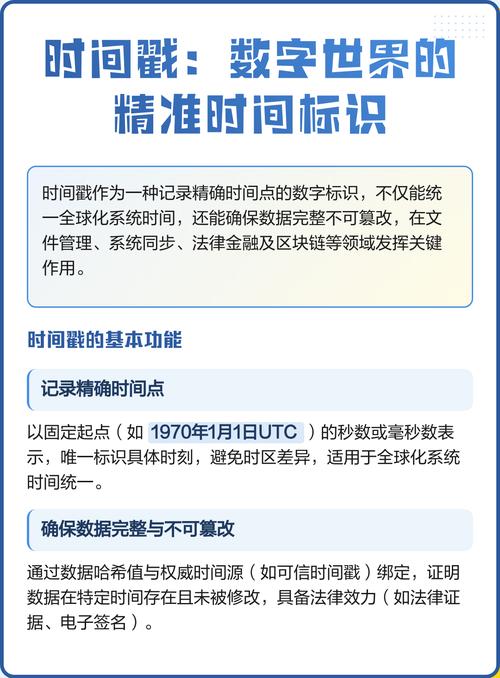
回到开头那个4.7秒。问题出在哪儿?PLC的扫描周期是10ms,但数据先写到本地缓冲区,再由OPC UA服务器以100ms的周期发布。边缘网关收到之后,打了一个自己的时间戳。可网关的NTP对时,跟MES服务器差了将近5秒。就是这么离谱。
工业数据汇聚里,时间同步的优先级被严重低估了。很多人觉得,数据到了就行,时间差不多就行。但你要做振动分析、做多设备联动诊断,时间差个几十毫秒,相位就全错了。
怎么解?分场景。对一般的过程数据,温度、液位、流量,NTP够用,毫秒级精度,成本低。但对高速运动控制、多轴同步、振动监测,得上IEEE 1588 PTP。PTP在硬件支持下能做到亚微秒级同步。当然,交换机得支持透明时钟,网卡得支持硬件时间戳。这一套下来,成本不低。
还有一个细节:时间戳到底打在哪一层?是PLC采集时打,还是网关收到时打,还是写入数据库时打?我的做法是,尽量在源头打。如果设备不支持,那就在边缘网关收到报文的那一刻打,并且记录网关与源设备之间的链路延迟估计值。别小看这个估计值,做数据对齐的时候有用。
采样率也是个大问题。温度信号,1Hz足够了。但液压系统的压力脉动,你至少得采到1kHz,否则高频成分全丢了。根据采样定理,采样频率要大于信号最高频率的两倍。但工程上,我一般取5到10倍。振动监测更夸张,10kHz起步。这意味着什么?意味着你的汇聚层吞吐量、存储成本、网络带宽,全都要重新算。
边缘算力放多少?这是一道成本与延迟的算术题
数据汇聚不是把数据一股脑传到云端就完事了。工业现场的网络,说实话,没那么可靠。专线会断,4G会抖,WiFi更别提。所以边缘侧得有一定的自治能力。
但边缘放多少算力?放少了,数据预处理做不了,脏数据全上云。放多了,成本飙升,而且现场维护是个噩梦。我的经验是,边缘侧至少要做三件事:协议转换、数据清洗、断网缓存。
协议转换不用多说。数据清洗,包括去重、去异常值、死区压缩。死区压缩特别有用。一个温度信号,如果五分钟内变化不超过0.1℃,那就没必要每个采样点都传。设置一个死区阈值,只在超出阈值时上报。这一下就能把数据量砍掉百分之七八十。别小看这个,云端的存储和计算成本,就是这么省下来的。
断网缓存,考验的是边缘网关的本地存储和续传能力。我见过一个坑:网关本地缓存用的是SD卡,结果车间震动大,SD卡松了,数据全丢。后来换成工业级eMMC,还加了看门狗,才稳住。

再说一个选型权衡。很多人纠结用软件网关还是硬件网关。软件网关跑在工控机上,灵活,能装各种驱动,但工控机的风扇、硬盘、操作系统,都是故障点。硬件网关,比如那些基于ARM的嵌入式盒子,稳定,功耗低,但扩展性差,算力有限。我的判断是:如果现场点数少于500,协议不超过三种,用硬件网关。超过这个量级,或者需要跑复杂算法,用工控机加软件方案。没有绝对的对错,就看你的场景。
数据模型不是IT的事,机械工程师得管命名

这一点我得拍桌子说。很多机械工程师觉得,数据汇聚是IT和自动化部门的事,自己把设备图纸画好就行了。错。大错特错。
设备的数据模型,本质上是对设备物理结构和行为的抽象。你让一个不懂机械的IT工程师去定义“液压泵站”的数据模型,他可能给你整出几十个孤立的数据点,流量、压力、温度、振动,彼此之间没有关联。但你知道,这几个量是耦合的。泵的出口压力跟流量、转速、油温都有关系。这个关系,应该在数据模型里体现出来。
现在行业里推得比较多的是OPC UA的信息模型,还有ISA-95的层级结构。ISA-95把企业分为五层,从现场设备到企业资源。数据汇聚时,至少要把设备层级理清楚:Enterprise → Site → Area → Work Center → Work Unit → Equipment。每个设备下面挂什么参数,参数之间什么关系,都得有定义。
命名规范也是。别用“Tag_001”“AI_002”这种名字。用有意义的标识,比如“Line1_Press_HydraulicPressure”。单位要统一,MPa还是bar,℃还是K,必须在模型里写死。我吃过亏,两个车间一个用MPa一个用bar,汇聚到中台之后,同一个指标差了10倍,报表出来的时候才发现。
还有一个坑:同一个物理量,不同设备厂家的编码器分辨率不一样,原始值需要做归一化。你不能直接把一个16位的原始值和一个32位的原始值放在一起比较。要在汇聚层做量纲统一,或者至少记录原始值和转换系数。
写在最后
工业数据汇聚这件事,技术栈在变,工具在变,但底层逻辑没怎么变。你得懂设备,懂工艺,懂数据从产生到消费的整条链路。别指望一个网关解决所有问题,也别把希望全寄托在云端。
每次项目上线前,我都会做一件事:拿一个最简单的数据点,从传感器到最终报表,完整走一遍。看看时延多少,看看精度丢了多少,看看断网之后会发生什么。这一遍走下来,心里就有底了。
至于那个4.7秒的问题?后来查出来是网关的NTP客户端配置错了,指向了一个已经下线的旧服务器。改完,重启,好了。就这么简单,也这么让人无语。
