工厂物联底座:从振动传感器到数据湖,一个机械工程师的踩坑实录

引子:一条产线停了,问题出在螺栓上,根子却在数据链上

去年冬天,我去苏北一家做精密减速机的厂子帮忙。凌晨两点,一条磨齿机产线突然报警停机。操作工说主轴振动值跳了。实际上主轴没坏,是拧在轴承座上的那个M8螺栓松了半圈。传感器测到了异常频谱,但数据在PLC里躺了十几分钟才被SCADA轮询走。等值班工程师看到报警,砂轮已经崩了边。 你瞧,我们谈物联底座,谈的从来不是云平台有多漂亮。是振动信号从加速度计出来那一刻,到最终触发停机指令,这中间到底走了多少冤枉路。说实话,这件事让我对“底座”两个字的理解彻底翻了个个儿——它跟数据量没关系,跟数据到达的确定性有关系。
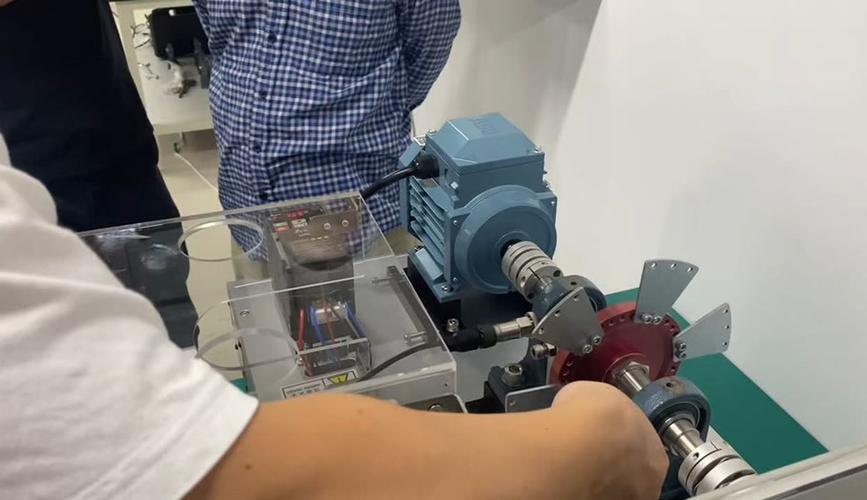
工厂车间设备振动传感器安装现场实拍
工厂车间设备振动传感器安装现场实拍

一、机械工程师容易忽略的第一层:物理量的语义化定义

一、机械工程师容易忽略的第一层:物理量的语义化定义
我第一份工作是做机床结构件设计的,后来转做设备状态监测系统。这个跨度里最大的坑,不是电气接线,也不是协议解析。是“这个测点到底在测什么”的定义混乱。 举个例子。你在减速机输入轴轴承座装了一个加速度计,采样率25.6kHz,量程±50g。PLC读到的是一个16位整数,对应电压值。上层算法拿到的却是“速度有效值 mm/s”。中间隔着一层积分、一层滤波、还有一个0.5Hz到10kHz的带通。问题来了——做设计的人关心的“振动烈度”是按ISO 10816-3来的,测的是壳体表面的宽带速度有效值。但状态监测算法工程师往往直接拿加速度频谱去做包络解调。这两个东西对同一个物理事件的敏感度完全不一样。 所以物联底座第一件事,不是搭Kafka集群。是在数据模型里把物理量的单位、量纲、参考坐标、测量方向全部固化成不可变属性。我见过一个厂,同一个轴承座上的测点,在MES里是“垂直振动”,在EAM里是“轴向加速度”,在边缘网关里变成“RMS Velocity”。三套系统三个名字,最后做故障诊断的时候,数据对不上,白白浪费了半年数据。 行业里有个通用参考,IEC 62541(OPC UA)的配套规范里,对旋转机械监测对象有标准信息模型。但说实话,国内很多集成商不用这套。为什么?因为它太细、太慢、太不灵活。一个中小型冲压车间的老板不会为了一个轴承测点去翻几百页的Part 100规范。这个时候底座设计者就要做取舍:你是要一个能用但不够精确的私有模型,还是等三个月去对齐国际标准?我的经验是,先跑起来,但预留映射层。私有模型里用tag path,后面加一个标准化映射表,参考VDI 3832的频带划分,后面随时能转。

二、边缘侧的时序对齐:你的Kafka消息可能全是乱的

好,假设物理量定义清楚了。第二个致命问题:时间戳。 很多工厂的传感器是通过Modbus RTU接入边缘网关的。Modbus本身没有时间戳概念。网关轮询到数据后,打上本机时间。问题是,网关的NTP同步可能偏了200毫秒。而同一台设备的振动传感器走IO-Link,IO-Link Master有自己的本地时钟,又偏了50毫秒。这两路数据到了边缘服务器上,做FFT分析的时候,相位差对不齐。 我吃过这个亏。一个风电齿轮箱测试台,齿面磨损特征频率在啮合频率附近。采集卡和PLC数据差了12毫秒,边频带整个糊掉,误判成轴承故障。后来查了三个月才发现是时间戳对齐的问题。
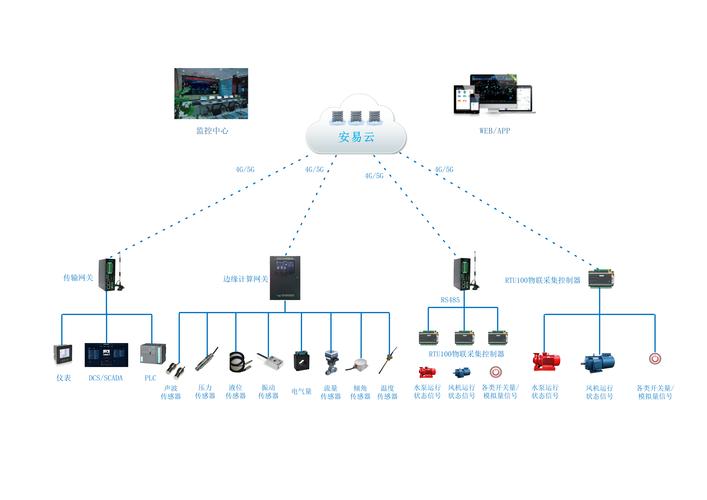
工业边缘网关设备接线与时间同步示意图
工业边缘网关设备接线与时间同步示意图
怎么解?我们在底座里强制了两件事。第一,所有边缘节点必须支持IEEE 1588 PTP,至少是软件时间戳模式,硬件时间戳更好。PTP在工业以太网里的精度能到亚微秒级,比NTP强两个数量级。第二,所有模拟量采样必须带硬件触发标记。什么意思?就是采集卡在采样时刻打一个硬件脉冲,这个脉冲同时送给网关做时间戳基准。这样即使网络有抖动,采样时间点是刚性的。 《机械振动 在非旋转部件上测量评价机器的振动》GB/T 6075.3里对测量不确定度有明确要求。如果时间对齐误差超过采样周期的1/10,频谱相位误差就会开始影响故障特征提取。你自己算一下,10kHz采样,周期100微秒,1/10就是10微秒。没有硬件对时,光靠软件打时间戳,根本做不到。

三、数据落湖之前,先想清楚“谁用、怎么用、用多久”

三、数据落湖之前,先想清楚“谁用、怎么用、用多久”
数据终于进来了,现在要落存储。很多方案一上来就是“数据湖”、“时序数据库”。说实话,我听到这两个词就头疼。不是技术不好,是绝大多数工厂根本不需要那么复杂的东西。 一个典型的离散制造车间,一条线20台设备,每台装4个振动测点、2个温度、1个电流。采样率按状态监测要求,振动波形取10kHz,温度1Hz,电流1kHz。一天下来原始数据量是多少?振动:20×4×10k×4字节×86400 ≈ 276 GB。温度和数据电流忽略不计。一天276GB,一年100TB。你确定要全部存下来? 这就是底座设计里的关键权衡。原始波形只保留触发前后的数据,或者按需回传。 我们现在的做法是:边缘侧做实时特征提取,缓存最近30秒的原始波形。当特征值超过阈值,或者收到上层的数据回传请求,再把波形上传。平时只传特征值,采样周期1分钟,数据量降到原来的万分之一。这样一年也就几十GB,用一台工控机加块SSD就扛住了。 如果是流程行业,比如石化、制药,情况又不一样。那些场合要求全量数据回传,因为合规审计要追溯到原始信号。那就要上真正的时序数据库,比如InfluxDB或TimescaleDB。但注意,时序数据库对高频振动数据并不友好。 我测过,单节点InfluxDB写入10kHz的浮点数,超过2000个测点就开始丢数据。这时候要么分片,要么降采样。没有银弹。 还有一点,OPC UA的信息模型和时序数据库的schema对齐,是最耗时的环节。 OPC UA里一个机器对象有几十个变量节点,每个节点有数据类型、工程单位、访问权限。时序数据库里你总不能每个变量建一张表吧?那得几千张表。我们的做法是加一个中间层,叫“物模型映射服务”。把OPC UA的NodeID映射成Tag ID,Tag ID再映射成时序库里的measurement+tag set组合。这个映射服务不做数据分析,只做翻译。这样上层应用不用关心底层是OPC UA还是Modbus,只管用Tag ID查数据。

四、说点实际的选型建议和踩过的坑

如果你现在要建一个工厂物联底座,预算有限,团队三四个人。我的建议很直接:别自己造协议栈。 协议解析那层,能用商业网关就用商业网关。Kepware、Ignition、或是国内的几家做边缘计算的。它们把Modbus、Profibus、EtherNet/IP、OPC UA、MQTT的适配都做好了。你非要用开源方案自己拼,光一个OPC UA的证书管理就能让你加班一个月。而且现场调试的时候,商业网关的抓包工具和日志系统能省你半条命。 数据库选型,先看数据保留策略再选技术。 如果只存特征值,SQLite都够用。如果要存原始波形,老老实实上对象存储(MinIO之类的),把时间序列索引放在PostgreSQL里。别用时序数据库存波形,你会在磁盘IO上撞墙的。 边缘计算和云端的分工要明确。 我的经验是:边缘侧做毫秒级响应的逻辑,比如超限停机、联锁保护、简单的阈值判断。云端做分钟级以上的分析,比如趋势预测、健康度评分、报表生成。中间的传输层用MQTT,QoS设1,别设2。QoS 2的握手开销太大,在车间网络不稳定的情况下反而更慢。 最后说个真实教训。有一个厂,物联底座做得非常漂亮,数据采集完整、存储规范、还有个可视化的驾驶舱。 但设备科的老师傅根本不看。为什么?因为他关心的是“这台压缩机今天能不能撑到下班”。你给他看频谱瀑布图,他看不懂。后来我们把界面改了,就一个大按钮:绿色“继续运行”、黄色“安排检修”、红色“立即停机”。旁边一行字:“预计剩余寿命:7天”。老师傅一看就懂了。 物联底座的价值,不在技术堆栈有多先进。在于是不是把正确的数据,在正确的时间,用正确的方式,送到了正确的人手里。 螺栓松了,信号传到了,停机指令下了,砂轮没崩。这事儿就算成了。

结论

结论
结论
工厂物联底座的本质,是机械物理世界和数字世界之间的确定性映射。 物理量定义要严、时间戳要对齐、数据传输要分级、存储策略要按用途来。技术选型上,能用成熟中间件的就别自己写协议栈。能把响应逻辑放在边缘的就别往云端推。至于标准,OPC UA和IEC 62541是方向,但落地的时候允许折衷。前提是,你的折衷点在哪里,自己心里要清楚。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:工厂物联底座:从振动传感器到数据湖,一个机械工程师的踩坑实录
文章链接:https://m.yqhljx.com/list_9/5951.html