摘要:现场总线各说各话,PLC 只认自己的地址空间,MES 只认 OPC UA 的信息模型。中间那层解析转换适配做得好不好,决定了整条产线的数据是「能用」还是「能信」。本文从字节序、语义映射、实时性分层三条线索切入,结合 Modbus、CANopen、PROFINET、OPC UA 的工程实例,讲清楚那些写在手册里、但没人明说的东西。
一、字节序:翻车最多的地方,往往是最不起眼的那一步
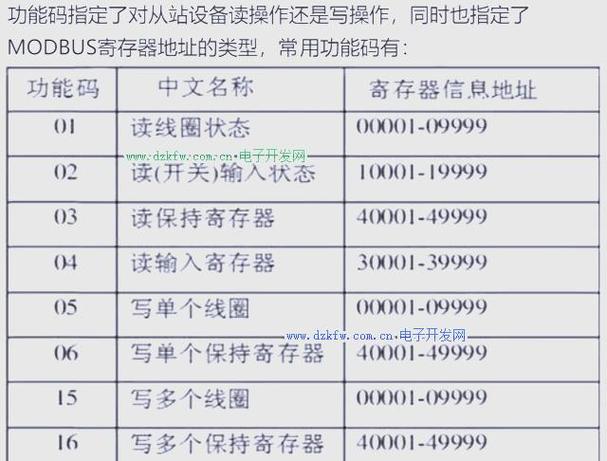
先讲个真事。某注塑车间,一台温控仪表走 Modbus RTU,40001 起两个寄存器放实测温度,32 位浮点。祖传代码读回来直接 unpack,屏幕上跳出来 1.4e-38。查了大半天——字交换。
说白了,Modbus 应用协议规范(V1.1b3)里只钉死了一件事:寄存器内部的两个字节按大端传输。至于 32 位量占用两个寄存器时谁在前,规范压根没说。于是市面上就有了四种流派:ABCD、CDAB、BADC、DCBA。西门子、施耐德、汇川、台达,各家默认都不一样,甚至同一家的不同固件版本还能给你换一换。
以 25.6 摄氏度为例。它的 IEEE 754 单精度编码是 0x41CCCCCD,拆成两个 16 位就是 0x41CC 与 0xCCCD。ABCD 排列下 R0=0x41CC、R1=0xCCCD;CDAB 就是 R0=0xCCCD、R1=0x41CC。差一位,数值天差地别。
我的一般做法是:先拿一个已知量去校准。让设备输出一个整数如 1000.0,读四个寄存器的原始字节,肉眼对一遍,比翻手册快。手册有时候是对的,有时候是「参考」。
还有标度变换。y = kx + b 这个式子谁都懂,可 k 的取值很讲究。温度动辄 0.1 甚至 0.01;变频器的输出频率常取 0.01 Hz,电流取 0.001 A。一旦 k 写错一位,数据看着还挺「正常」,就是全错。这在调试阶段最难发现——它不报警,也没人觉得不对。
二、语义鸿沟:地址对上了,意思没对上
字节序解决的是「怎么读」,语义解决的是「读出来是什么」。这两件事从来不是一回事。
举个现场常见的:某台设备的 status word 是 16 位,bit 3 是过载报警,bit 7 是就绪,bit 12 到 14 是个三位枚举表示运行阶段。上位机要的是三个独立变量加一个枚举量,中间就得靠位运算拆。
公式很朴素:value = (raw >> shift) & mask。坑在于 mask 的边界怎么写。同事的代码里两种写法都出现过——有人写 0x07,有人写 0x38。后来我们统一规定:mask 只写移位之后的位数掩码,三位就是 0x07,不是 0x38。省了很多口舌。

再往上就是信息模型。IEC 62541 定义了 OPC UA 的地址空间与类型系统,NodeId 只是入口,真正要命的是 DataType、EngineeringUnits 这几个属性。同一个 0x2001 寄存器,在设备侧是「1 表示 50 Hz 档」,在 OPC UA 侧就得是 Double 类型的 50.0,还挂上 EngineeringUnits 为 Hz。这一步不做,MES 拿到个 1,完全不知道那是什么意思。
注塑行业有个现成的参照:Euromap 77 与 83。前者规定了注塑机与 MES 之间基于 OPC UA 的接口,后者定义了配套的类型与语义。你要是自己造一套私有映射,短期能跑,长期一定被替换掉。能用行业 Companion Specification 就别自创,这话真不是吓唬人。
三、实时性:别让 1 ms 的数据去挤 100 ms 的通道

很多人一上手就想把所有数据都往上搬,越快越好。这个念头很危险。
现场的数据是有层次感的。伺服驱动器的电流环可能 62.5 µs 一次;PROFINET IRT 的周期可以压到 250 µs;CANopen 在 1 Mbps 下传一帧 8 字节 PDO,光仲裁加传输也要一百多微秒。这些东西是给本地闭环用的。上层的 MES 到底关心什么?一秒一次的温度、五秒一次的产量,足矣。
所以我的分层原则很直白:快数据留在本地控制器里闭环,慢数据才过网关。网关不是越强越好,够用就好。一块 Cortex-A7 双核 800 MHz 的板子,跑 1000 个点位、50 ms 的轮询周期,CPU 占用大概四成。你要硬上 10 ms,也不是不行,抖动会立刻变得很难看。
抖动这事得单独说。轮询周期标称 100 ms,实际到达时间在 92 到 118 之间跳,这是常态。工程上一般要求 jitter 控制在标称周期的 10% 以内,超了,上层做趋势分析就会看到锯齿。
另外,时间戳比数值本身更容易被忽略。IEC 60870-5-104 用 CP56Time2a 的 7 字节时间,精度到毫秒,年份只给 7 位(0 到 99),跨世纪会绕回去。OPC UA 的 DataValue 分 SourceTimestamp 和 ServerTimestamp,采集侧一定填前者。填成服务器收到的时间,那你这批数据就只反映了「网关什么时候活着」。
四、几个真实的坑,列出来省得你们再踩
CANopen 这块。对象字典 0x2000 到 0x5FFF 是厂商自定义区,PDO 映射改起来麻烦,但 EDS 文件一定要拿全。缺了 EDS,你连 0x1A00 里映射了哪几个对象都得靠猜。还有,TPDO1 的默认 COB-ID 是 0x180 + NodeID,RPDO1 是 0x200 + NodeID,别看反了。
断线重连。很多网关掉了线之后,值就冻结在最后一个数上,上层完全察觉不到。质量戳(Quality)是必需品,OPC UA 里就是 StatusCode 的 Bad 系列。宁可让数据缺失,也不要给一个假的好数据——这比没有数据危险得多。
缓冲策略。网络总要抖一下,环形缓冲开 4096 到 8192 条,满了之后是丢最旧的还是拒新的,得按业务定。遥测可以丢,事件不能丢。
还有一个,类型转换。整型到浮点没问题,浮点到整型要明确是截断还是四舍五入,是饱和还是环绕。我见过一个累加计数器,超过 32767 之后翻负,报表上产量直接变成负值。嗯,就那么回事。
收尾
做适配层的人,心里得装着三张图:字节层面的位图、语义层面的模型图、时间层面的调度图。这三张对上了,中间那层就「不显眼」了。而一个不显眼的适配层,恰恰是最好的适配层。
真要说有什么经验,就一句:先把第二个字节校准,再谈架构。
