摘要:很多制造企业花大价钱上了数据采集系统,到头来发现手里攒了几个T的数据,真要用来做质量预测、故障预警的时候,全用不了。本文从汽车冲压车间的实际项目出发,聊工业数据深度治理的落地逻辑,讲真坑,给实招,适合准备碰工业数据项目的中级工程师参考。
为什么你手里的工业数据全是垃圾
三年前我在国内某头部车企的零配件冲压车间做项目,甲方说我们已经有全套MES,数据全存了,你们直接拿来做质量预测就行。
我打开数据库一看,差点背过气。
1200吨闭式双点压力机的压力数据,每分钟固定采10个点,换模的时候停线17分钟,一整页全是零值,没人标记停线状态。车间四个进口压力传感器,两年没按规范校准,最大偏差快80吨,你说这数据拿来算成形力,能准吗?
更离谱的是,原料批次数据,因为供应商换了编码规则,去年的编码和今年的对不上,同一炉料拆成了三个不同批次,混在数据集里。
说实话,百分之八十的工业数据项目死在第一步,就是没人愿意沉下心做深度治理,都想着搭完平台直接上大模型,结果巧妇难为无米之炊。
工业数据深度治理的核心:对齐业务逻辑的标签体系
很多人觉得数据治理就是删掉异常值,补全空值,那是最基础的清洗,算不上深度治理。
我们当时推翻了原来的数据体系,完全按照GB/T 41600-2022《工业数据分类与编码》的规范重新梳理,核心就一件事:从采集端就给每一条数据绑定业务标签,不是到后端分析的时候才补。
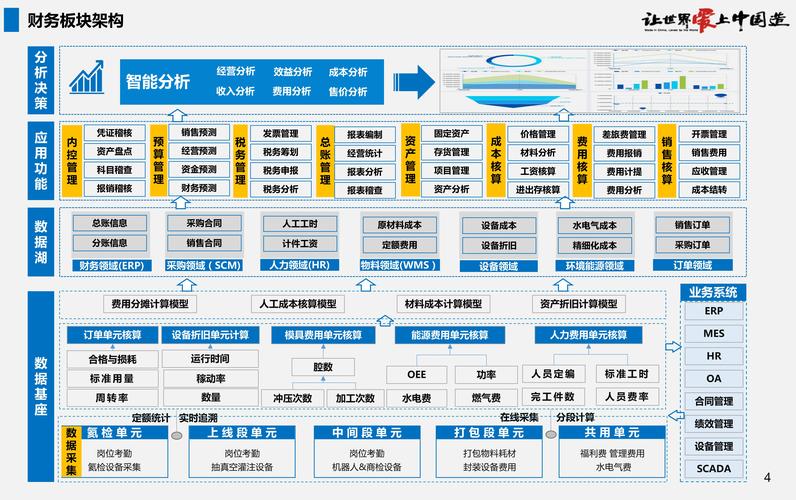
举个例子,原来质量标签只有两个值:合格、不合格。我们呢,拆成了12个细分标签:开裂、起皱、偏模、厚度超差、原料硬度异常…每一个不合格都对应到具体的工艺环节,同时把工位号、模具编号、冲压次数、原料批次、车间环境温度这些元数据,直接和每一条压力、振动数据绑死。
原来我们找100个开裂件的有效样本,工程师翻了三天报表,最后一半标签对不上,作废。改完标签体系之后呢,十分钟就能拉出干净的、符合要求的数据集。
不过话说回来,做标签体系不是越细越好,我们一开始差点把每一颗螺丝的编号都加上,后来发现根本没用,反而增加存储和计算量,只要对齐你要解决的业务问题就行,对吧?
落地时最容易踩的三个暗坑
这几个坑都是我们项目组花了几十万学费踩出来的,记好。
第一个坑:过度采集。很多设备厂商卖采集卡,跟你说频率越高越好,我们一开始信了,给主轴振动加了100Hz采样,一天单台设备出2.3G数据,一个车间一个月就是小两百T,存储成本翻了三倍,训练模型的时候慢到崩溃。后来我们跟老钳工聊,冲压机的故障特征频率最高也就8Hz,留够冗余10Hz完全够用,多余的数据全是垃圾。钱烧了一大半,打了水漂。
第二个坑:人工标注数据错漏。我们一开始图省事,把质检员手写的质量记录直接OCR录入进数据库,模型训出来准确率一直卡在83%,调了半个月算法都没用。后来我们抱着试试的心态翻原始手写本核对,才发现三分之一的标注错了——OCR把“4.2mm”认成“1.2mm”,质检员笔误把合格划成不合格,这种错误比传感器漂移还坑。现在我们要求所有人工标注必须双人复核,关键数据抽样现场核对,麻烦是麻烦点,但总比项目黄了强。
第三个坑:一劳永逸。很多企业做完一次治理,就把数据扔那不管了,哪有这么好的事?冲压模具冲一万次就会磨损,成形压力阈值就会变,工艺改了,原料换了供应商,数据分布全变了,你还用原来的规则治理,出来的结果肯定错。深度治理不是一劳永逸的项目,是跟着生产走的日常工作,每个季度跟着设备保养、工艺更新调一次规则,这才对。
最后说两句
工业数据深度治理,本质不是做数据活,是做工业活。你得下车间摸过模具,跟老技工聊过换模的坑,知道哪个参数对质量影响大,才能做对治理规则。坐在办公室对着数据库写脚本,永远做不出能用的工业数据。
现在吹工业大数据的多,真沉下心做治理的少,谁先把这件事做实,谁就能拿到真正能用的结果。
