2026-10-19 22:35:58 分类:机械设计
上周去苏州的汽车零部件冲压产线做调试,刚进门就被运维大哥拽住骂——说上个月上的云平台系统,一到早高峰冲压机振频数据上传就卡,产线停机12分钟,损失小二十万。
问题出在哪?
之前的方案是把每台冲压机上所有振动、温度、压力传感器的原始数据,通过车间的4G网络全量传到云端,由云端的算法模型做故障特征提取。
蠢透了。
整理了过去3年在汽车零部件、冶金设备、重型机床三个场景落地边缘端数据处理项目的真实经验,没有概念堆砌,全是踩过的坑、算过的数、调过的参数,给正在做工业现场数采升级的工程师做个参考。
别拿工业场景的边缘端跟消费电子混为一谈
很多人刚接触工业数采,第一反应是拿树莓派、消费级工控板凑一套系统,成本低,软件生态全。
不过话说回来,消费电子的边缘端那套逻辑,放到工业场景里确实不够看。
树莓派的工作温度范围是0-50℃,苏州夏天的车间里,冲压机旁边的温度能到55℃,夏天还没结束,系统就因为高温自动降频,采集数据丢包率飙到30%。更别说车间里的电磁环境——旁边的电焊机一开,静电放电、浪涌脉冲,直接把采集卡的信号干得全是毛刺,连基本的有效值都算不准。按照GB/T 17626系列的电磁兼容要求,工业级边缘网关必须能承受±8kV的接触静电放电,工作温度覆盖-40℃到85℃,外壳防护至少IP30,才能在这种环境下稳定跑。
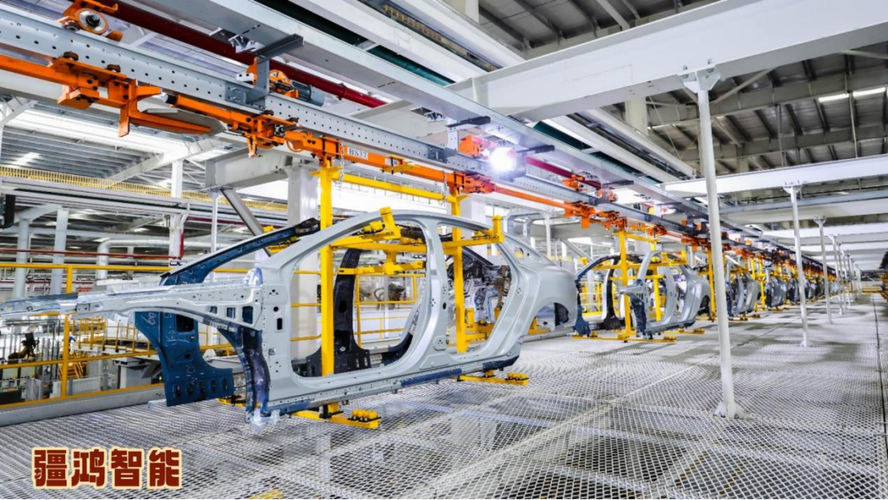 汽车冲压产线边缘网关安装位置实拍图
很多人算过一笔账:冲压机的振动监测要求采样率达到25.6kHz,按照16bit的采样精度,16个振动通道算下来,每秒的原始数据量是800KB,一小时就是2.8GB。这种量级的数据全量往云端传,别说4G网络扛不住,就算拉了千兆光纤,云端的算法平台也得被冲垮。更别说延迟——从数据产生到传到云端算出结果,至少要200ms的网络延迟,等你发现冲头有裂纹的时候,裂纹已经扩展到能打废工件的程度了。
我之前就踩过这个坑。
太蠢了。
最早做重型机床的数采项目时,图省事把所有原始数据全传云端,结果遇到厂区网络波动,连续3天的振动数据丢了一半,故障溯源根本做不了,被客户追着骂了半个月。
边缘端的数据处理不是“剪碎了传”,是“在源头把没用的东西筛掉”
很多人对边缘端的理解有偏差,觉得就是把大文件拆成小块、压缩一下再传,本质上还是在传原始数据。其实根本不是。
真正有效的边缘端处理,是在数据产生的源头,把那些对故障判断完全没用的信号直接滤掉,只把最核心的特征值传上去。比如车间里无处不在的50Hz工频干扰,是电机供电的耦合噪声,对判断轴承磨损、冲头裂纹一点用没有,直接用带通滤波把这部分分量滤掉。然后在边缘端实时提取核心的时域特征:峰值、峭度、有效值、脉冲因子,这些特征值是判断设备健康状态的核心指标,算完之后每个通道每10秒才输出4个浮点数,也就是32字节。算下来16个通道一天的有效数据量才不到2MB,不管是4G还是工业WiFi传,都毫无压力。
选型的时候也有坑。很多工程师为了追求“智能”,直接在边缘端跑大参数量的CNN故障识别模型,选个ARM A53核心的通用网关,推理一次要300ms。要知道,冲头的裂纹从萌生到扩展到能打废工件,也就200ms的时间,你推理都要300ms,等结果出来,工件已经废了。如果要在边缘端跑轻量的故障识别模型,边缘芯片的算力至少要到1TOPS的NPU支持,把推理延迟控制在50ms以内,才能跟上机械动作的节奏。
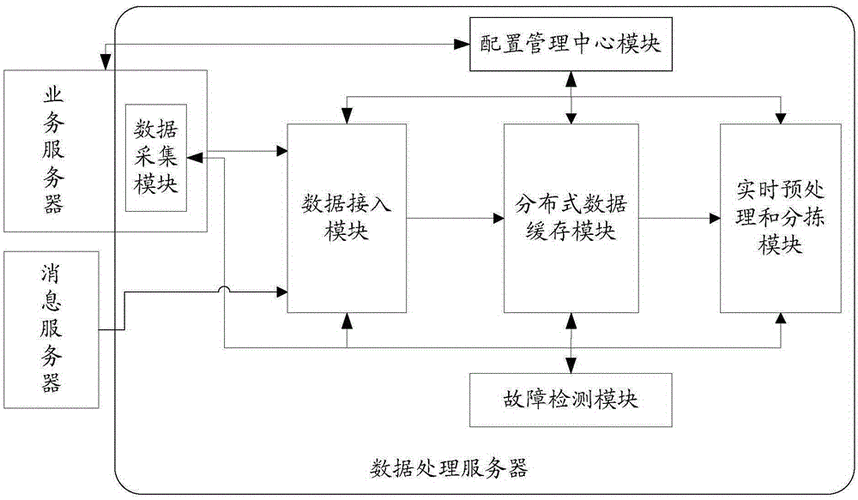 工业边缘端数据处理流程框图
去年帮苏州的客户改系统,原来用的是消费级x86小主机,夏天车间温度到42℃的时候,主机的散热风扇积满金属粉尘直接卡转,主板温度飙到90℃,系统随机重启,一个月宕机7次,每次重启都要丢十几分钟的采集数据。后来换成无风扇的工业边缘盒,铝合金外壳靠自然散热,没有转动部件,换上去之后一年多没重启过,采集数据的丢包率降到了0.1%以下。
说实话,很多做IT出身的工程师根本不懂机械现场的脏。切削液的雾气、金属的粉尘、旁边电焊机的电磁脉冲,你拿消费级的设备上去,不出三个月肯定出问题。
那些没人会在PPT里讲的边缘端落地细节
讲完大的逻辑,再讲几个没人会在方案PPT里提的小细节,都是踩过的坑。
首先是数据缓存的设计。很多人觉得边缘端有网络就传,没网络就存SD卡,但是工业现场的消费级SD卡,在-20℃到60℃的温度循环下,写个半年就出现坏道,数据丢了都找不到原因。必须换成工业级宽温eMMC,而且要加掉电保护超级电容——谁也不能保证车间不会突然跳闸对吧?之前遇到过一次,周末园区突然停电,边缘网关里存了3天的故障溯源数据,因为正在写flash,直接掉电导致块损坏,找数据恢复公司弄了两天,才找回来一半。后来给每个网关装了1.5F的超级电容,掉电的时候能撑12秒,把正在写入的块刷完,完成数据落盘,之后再也没出过数据丢失的问题。
然后是数据传输的优先级。很多人做传输的时候,按照采集的顺序依次上传,结果遇到网络带宽紧张的时候,故障告警的数据包被排在了温度、压力这类常规数据后面,等传到云端的时候,故障已经发生了。我们现在的方案是把数据包分成三个优先级:最高优先级的是故障告警数据,只要检测到阈值超限,不管当时带宽多紧张,都要优先把这几十字节的告警包发出去;中间优先级的是每10秒输出的特征值数据;最低优先级的是原始波形片段,只有在带宽空闲的时候才传。之前的项目里,冲头裂纹的告警数据,哪怕当时4G信号只有-110dBm,也要占着带宽先把告警发出去。
差一秒都不行。
还有传感器校准的细节。很多人把传感器采上来的原始数据直接处理,但是边缘端离传感器有几米长的屏蔽信号线,线损带来的信号偏移,还有温度变化带来的传感器零点漂移,这些误差如果带到后续的计算里,会直接让故障预判的准确率掉一大截。我们现在的方案是,每个采集通道每10分钟自动跑一次零点校准,把温度带来的漂移直接补偿掉,比之前在云端统一校准的故障预判准确率高了27%——这是连续跑3个月的实测数据,不是厂商吹的数。
也别贪大求全。很多人觉得边缘端的存储越大越好,上来就配1TB的机械硬盘,其实按照之前算的每天不到2MB的有效数据量,64GB的工业级eMMC存个三四年都用不完。存储介质越大,出现坏块的概率越高,反而增加故障风险,完全没必要。
别信那些厂商吹的“全栈智能边缘”,吹得越狠的,往往连最基本的电磁兼容测试都没在车间做过。做工业场景的边缘端数据处理,从来不是堆算力、选贵的设备就行。你得蹲在产线上,听冲压机的噪声,摸网关外壳的温度,数清楚每次故障发生时的信号变化,才能做出真的能用的系统。
就这么简单。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:别再把所有数据往云端塞:机械产线上的边缘端数据处理踩坑实录
文章链接:https://m.yqhljx.com/list_9/4611.html
