上周在汽车焊接车间蹲了3天,盯着那套跑了半年的AI缺陷识别系统,刚拍了桌子骂完——它把焊缝边缘的飞溅当裂纹报的概率,居然快赶上老检验员摸鱼漏检的数了。
我做机械工艺出身,转做AI落地快4年,见过太多同行拿着开源模型就往车间里塞的蠢事。
真的。
那些在Demo里能精准识别99%缺陷的系统,一到真实生产线上,不是被油污糊了摄像头,就是把拉延筋的流痕当开裂报,最后落得个“花了几百万买了个手电筒”的下场。
别迷信开源模型,先把你的“缺陷定义”对齐GB/T 3323
很多人上来就拉个YOLOv8的开源权重,对着网上找的焊接缺陷数据集就微调。
停。
你有没有想过,网上那些数据集的“缺陷定义”,根本不是你车间要执行的标准?
我们去年给某新能源车企做的冲压件缺陷识别项目,一开始用的是从某开源平台下的1500张冲压件缺陷图,标完训练出来的模型,在实验室里mAP能到91%。结果拉到客户现场,直接被QC打回——因为我们把“拉延筋处的轻微流痕”标成了合格,而客户执行的QC/T 1095-2016《汽车冲压件质量评价方法》里,明确规定流痕深度超过0.05mm就是不合格。
那批数据我重新标了1200张。
翻标准翻到凌晨3点才发现,我们默认的“合格阈值”,比客户的工艺要求松了整整0.03mm。
AI缺陷识别的核心,从来不是模型有多先进,而是你给它的“对错标准”,是不是和现场执行的行业规范完全对齐。
举个最常见的例子:GB/T 3323-2019《金属熔化焊焊接接头射线照相》里,把焊接缺陷分成了6大类,每一类的合格阈值都和板厚、接头形式直接挂钩——比如板厚10mm的对接接头,Ⅱ级焊缝里允许的气孔直径最大是4mm,而Ⅰ级焊缝是完全不允许有任何裂纹、未焊透的。
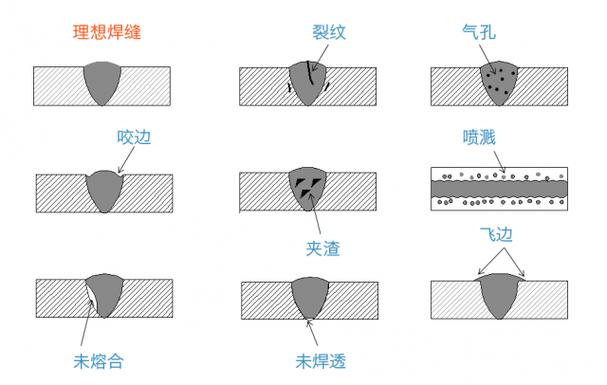
你要是拿开源数据集里的“暗斑=缺陷”的逻辑去训练,根本分不清哪个是允许的气孔,哪个是致命的裂纹。
说实话,标数据的人要是不懂工艺,AI就是个瞎猜的傻子。
部署端的权衡:边缘盒的算力,真的够你跑“高精度模型”吗
很多人训练的时候,非得用最大的YOLOv8x模型,就为了那2%的mAP提升。
然后呢?
部署到车间的边缘盒上,帧率直接从训练时的60fps掉到12fps,再加上车间里焊机的电磁谐波干扰,摄像头丢帧15%,推理延迟从100ms涨到300ms——刚好赶上生产线的节拍是每2秒一个零件,结果就是:刚要推理完,下一个零件已经过来了,直接漏检。
我们做铸件砂眼识别的时候踩过这个坑。
一开始用的YOLOv8x,mAP 92.3%,但是在Jetson Xavier NX上跑,帧率只有11fps。后来我们换了YOLOv8s,把训练集里加了20%的带型砂残留、带浇口余痕的样本,调整了标注的精度,最后mAP只掉了3.1%,但是帧率直接涨到47fps——就算丢20%的帧,也能保证每个零件有至少3次推理机会。
边缘端的AI缺陷识别,永远是“够用就好”,而不是“精度越高越好”。
毕竟生产线不会等你的模型慢慢推理。
不过话说回来,选边缘盒的时候,别光看算力参数。我们之前踩过另一个坑:买了个标称算力21TOPS的边缘盒,结果车间里的温度是42℃(夏天的焊接车间),它直接降频到5TOPS,帧率又掉了一半。后来换了带主动散热、工作温度范围-20℃到60℃的工业级边缘盒,才稳住帧率。
别忽略“误报成本”:这才是你系统能不能落地的关键
很多同行做AI缺陷识别,只盯着mAP、漏检率这两个参数,根本不算误报的账。
对吧?
你算过吗?
汽车焊装线的节拍损失,每停1分钟是200块;要是一个焊缝裂纹流出到主机厂,索赔金额是5000块。那你的系统,是要把误报率压到1%,还是把漏检率压到0.1%?
我们给系统加了个“动态置信度阈值”模块——这是我们自己攒的小技巧,不是什么高大上的算法。
逻辑很简单:误报成本=误报率×停线时间×单位时间损失;漏报成本=漏检率×缺陷流出后的索赔金额。我们要找的,是让这两个成本之和最小的置信度阈值。
比如焊缝的裂纹,漏报成本极高,我们就把置信度阈值设成0.6——只要模型觉得有60%的可能是裂纹,就报警,哪怕误报率高一点也没关系;而表面的轻微划痕,漏报成本很低,我们就把阈值设成0.9——只有模型觉得90%是划痕,才报警,尽量少打扰检验员。
这个模块加上之后,我们系统的误报率从18%降到了4%,检验员的复检工作量直接减了70%。
老检验员终于不用对着AI的报警声骂娘了。
上周跟车间的张师傅聊天,他做了20年焊缝检验,眼睛现在还有点散光。他说,AI最有用的地方,不是替他挑毛病,是帮他把那些看了一天眼睛都花了的小缺陷先筛出来——他只需要对着AI筛出来的可疑点,再确认一遍就行。
别把AI当神。
它就是个帮你省眼睛的工具。
要是有人跟你说,AI缺陷识别能完全替代人工检验,你直接把他拉到焊接车间蹲3天,闻闻那股焊烟的味道,看看那忽明忽暗的光线,再看看那满是飞溅的焊缝——他就知道自己说的是屁话了。
