上个月跑了三家长三角的制造工厂,光拆老设备的通讯线就耗了整整四天。
你说折腾不折腾?
很多人一提工厂物联数据底座支撑平台,第一反应是买个顶配云服务器、接个大屏做数字孪生,拍个视频给领导看就完事。真到了要拿数据算模具磨损、算设备OEE的时候,才发现存了大半年的数,全是没用的垃圾。
先把“底座”的定义掰明白:不是买个云资源池就叫底座
之前碰到过一家做汽车冲压件的工厂,2022年花了近百万上了一套所谓的“物联平台”,存了3个月的冲压滑块位移、模具温度数据,想拉出来算下一副模具的实际磨损量,结果一比对才发现,12台冲压机的PLC上传的时间戳,最大的差了17秒。
17秒是什么概念?
冲压机一个循环才2.8秒。
差17秒的数据,根本对不上任何一个冲压动作,算出来的磨损值偏差能超过30%,完全没有参考价值。
按照GB/T 33863.3-2017《可编程控制器(PLC) 第3部分:编程语言》的明确要求,工业现场跨设备的时钟同步精度不能超过10ms——这是所有后续数据分析的基础,基础错了,后面建再多的模型、做再多的大屏,全是空中楼阁。

说实话,大部分厂商给的方案里,根本不会提时钟同步的细节。毕竟要把10ms级的同步精度做落地,得在每个边缘节点上接GPS时钟模块,还要处理现场变频器、焊机带来的电磁干扰,麻烦得很,远不如直接把数据传到云端看着好看。
我们之前给那家冲压厂补做时钟同步的时候,光屏蔽线就换了300多米,把原来的非屏蔽双绞线全换成了带金属编织层的Profibus电缆,前后调试了两天,才把所有节点的时间差压到6ms以内。就这,还是在冲压车间满负荷生产的状态下测出来的。
选型时最容易漏算的三个隐性成本
很多人算物联底座的成本,就盯着服务器、网关的采购价算,根本不算那些藏在落地环节的隐形成本。
第一个,通讯协议的适配成本。
别以为现在的设备都是标准OPC UA接口,我上次在南通的一家重型机床厂,碰到12台90年代出厂的立式车床,用的是西门子S5系列的老PLC,市面上卖的通用网关根本读不到主轴负载的实时值——这些老设备的寄存器映射表,西门子早就不提供公开文档了,我们为了把电流值读出来,硬对着寄存器地址的数值变化,写了200多行的自定义映射逻辑,折腾了整整一周。
就这,还是因为我们团队之前拆过同型号的PLC,有经验。要是没碰过,光找寄存器映射关系,能耗上一个月。
第二个,边缘侧的算力冗余。
别算着当前要接100路数据,就选刚好能跑100路的最小配置边缘盒。去年有个客户图便宜,选的边缘盒CPU最大负载是120路数采,当时算着刚好,后来要给磨床加视觉检测的毛刺识别功能,边缘盒直接卡死,CPU占满100%,现场数采断了两个小时,连累MES系统报不出当日的实际产量,被生产经理追着骂了三公里。
第三个,数据清洗的规则内置成本。
现场的数采数据哪有那么干净?冲压车间的变频器一开,数采的电流值能飘出来30%的无意义尖峰;焊机工作的时候,模拟量通道的电压值能直接跳满量程。这些垃圾数据要是直接传到数据库,后面算出来的OEE、设备故障率,全是错的。

我们现在做的底座,会在边缘侧提前把这些干扰值滤掉——比如连续3个采样点的数值跳变超过量程的20%,直接标记为无效值,根本不往上传。就这一个简单的规则,能帮客户省掉后面70%的数据清洗工作量。
别把所有数据都往中心数据库塞:分层存储的实际阈值
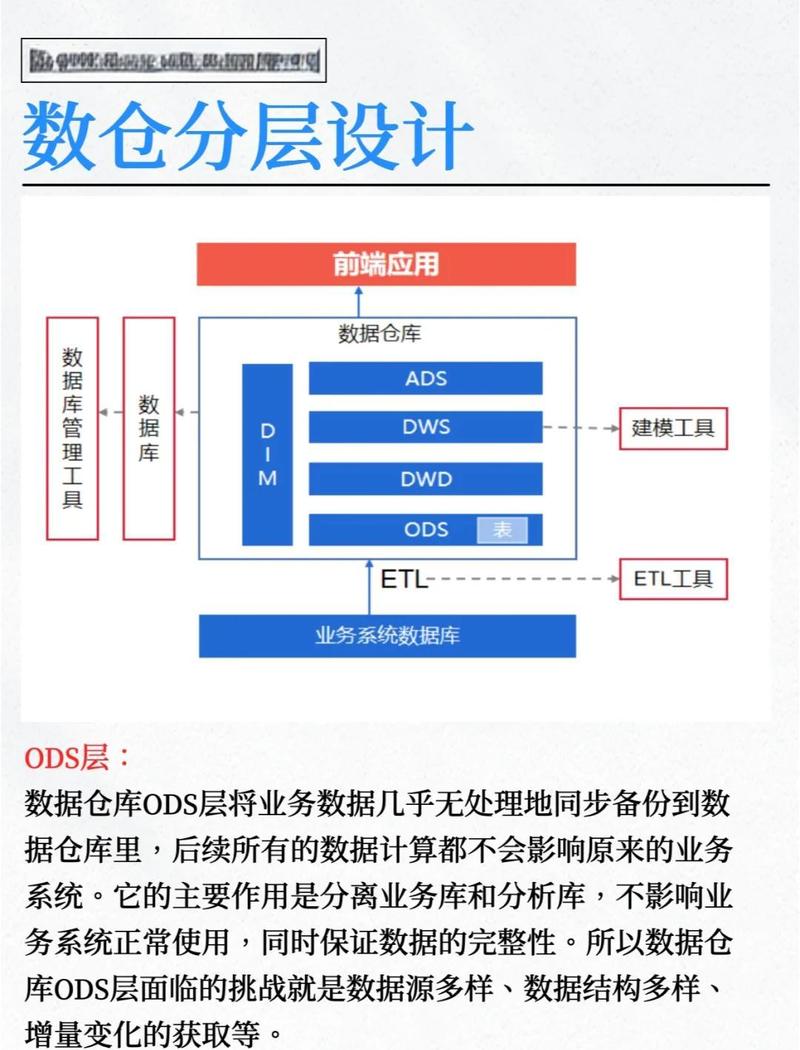
很多厂做物联底座,总想着“数据全量上云”,觉得存的越多越好。
真的算笔账你就知道有多离谱。
我们按1000个数采点来算,每个点的采样频率是10Hz,单个浮点值占8字节,一天的原始数据量是多少?
1000 * 10 * 86400 * 8 = 6.912GB。
这还没算协议传输的开销。如果真把这些数据全传到中心云,10个这样的车间,一年的原始数据量就是25TB,光云存储的费用,一年就要小十几万,还不算带宽成本。
更离谱的是,之前碰到个同行做的方案,把每台设备的振动数据(采样频率25.6kHz)全传到中心,结果第三个月的带宽账单超了预算3倍,被财务直接打回重做。
蠢不蠢?
按照我们这几年落地的实际经验,分层存储的阈值其实非常明确:
第一类,需要实时响应的数据——比如液压机的压力值、冲压滑块的位置、电机的振动加速度,只要采样频率高于10Hz,就存在边缘侧的时序数据库里,响应延迟要压到50ms以内。这些数据本来就是用来做实时故障预警的,传去中心云绕一圈,延迟高了根本起不到预警作用。
第二类,按班次、按小时汇总的统计数据——比如单台设备的当班产量、平均负载、累计运行时长,这些数据存在本地的关系库里,每天固定时间同步到中心平台就行,根本不需要实时传。
第三类,需要长期追溯的历史数据——比如设备的维修记录、模具的全生命周期磨损曲线,这些才需要存在中心的长期存储里,供后续的工艺优化用。
上次在苏州的一家精密轴承厂,我们把原来的全量上云的存储架构改成分层存储之后,查询历史磨床主轴温度的速度,从原来的12秒降到了0.3秒。当时负责数据的小姑娘都惊了,说之前查个上周的温度值,要等咖啡泡好才能出结果,现在刚点完查询,数就出来了。
其实我们现在做的这套底座,完全是按照GB/T 41255-2022《工业互联网平台 边缘计算 总体架构》的规范来搭的,没有什么花里胡哨的功能。
真的。
很多人总觉得工厂物联数据底座支撑平台是个高大上的互联网项目,要搞数字孪生、要搞AI大模型才算先进。
说白了,这东西本质上就是把现场那些飘在空气里、藏在设备寄存器里的零散信号,变成能直接用来算成本、提效率的有效数字的过程。
别被厂商的销售话术忽悠了。什么“全栈自研”“全域感知”,先把时钟同步做准、把协议适配做稳、把分层存储算明白,比什么都强。
