2026-11-16 09:08:17 分类:机械设计
凌晨两点,焊装线MES又报警了。OPC UA 订阅掉线,补传队列堵在网关里。那一刻你会明白,产线数据存储不是“找个数据库写进去”这么简单。它夹在PLC扫描周期、现场总线抖动、MES追溯、工艺质量分析之间,任何一环掉链子,最后都变成你半夜爬起来查日志。
先算一笔账:10ms采样到底有多凶
某总装线,2000个测点,工艺要求10ms记录一次。别急着拍板。算一下:2000 × 100Hz = 200000 点/秒。每个点如果按 时间戳8B + 值8B + 质量4B + 测点ID4B = 24B,原始写入 4.8MB/s。一天 4.8 × 86400 ≈ 414GB。一个月 12TB。如果没有压缩、没有降采样、没有保留策略,单机 MySQL 会死得很难看。InnoDB 的 B+ 树页分裂、redo log、双写缓冲,每一条 insert 都是一次随机 I/O。机械硬盘 IOPS 根本扛不住,SATA SSD 也撑不了多久。
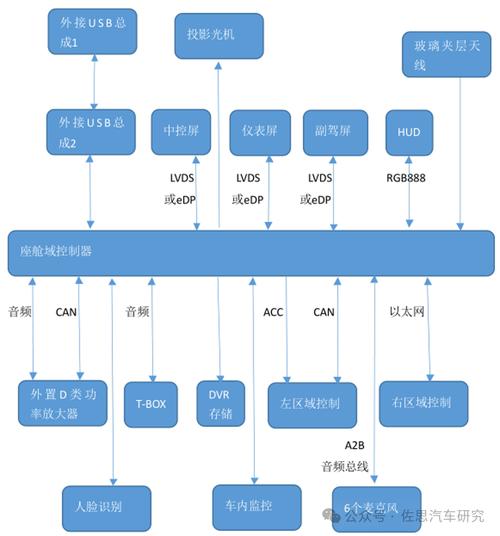 汽车总装线高频测点数据量估算与存储架构图
但实际现场不会这么理想。很多测点变化很慢,温度、压力、扭矩,死区压缩能砍掉 80% 以上。OPC UA 订阅有采样间隔和队列深度,不是每个扫描周期都上报。真正难的是突发。比如拧紧枪触发、视觉结果下发、机器人焊接电流曲线,这些数据会瞬间把缓冲打满。所以存储层要能扛峰值,不是看平均值。
经验:按峰值带宽的 1.5 到 2 倍设计写入能力,别按日均值。 这句话值几次通宵。
时序数据库不是银弹,选型得看写入模型
PI System 老牌,稳,贵,生态封闭。InfluxDB 上手快,行协议简单,但高基数会爆内存。TimescaleDB 基于 PostgreSQL,SQL 友好,适合和业务表 join,但写入吞吐受限于 PG 的 WAL 和 autovacuum。TDengine 在国产产线里越来越多,超级表模型对设备测点很友好,压缩率也漂亮。可你得想清楚:查询模式是什么?是“查某台设备某测点最近一小时曲线”,还是“按批次追溯所有工艺参数”,还是“跑 SPC 统计过程控制”。
如果只是单线,几千测点,边缘网关本地缓存 + 轻量时序库足够。如果是集团多工厂,几十万测点,Kafka + 对象存储 + 数据湖更合适。别一上来就微服务、数据中台。产线停机等不起。
 工业产线边缘网关断点续传与消息队列缓存架构场景图
有个坑我踩过:用 Redis 做实时缓存,觉得快。结果 AOF 重写时 CPU 飙高,网关写入阻塞,OPC UA 订阅队列溢出,丢了一批扭矩数据。客户直接投诉到质量部。后来改成内存环形缓冲区 + 本地 SQLite 批量落盘,牺牲一点实时性,换来了确定性。对吧,产线要的是确定性,不是 benchmark 跑分。
写入路径越短越好。每加一跳,就多一个故障点。
时间戳、质量戳,一个都不能少
很多团队只存时间、测点、值。等到分析时发现:数据跳变,分不清是工艺异常还是通讯闪断。OPC UA 的 StatusCode 必须存。质量戳 0 表示 Good,0xC0000000 表示 Bad,0x4000000 表示 Uncertain。别把它当布尔值。我见过把质量戳转成 tinyint 的,结果所有非零都变成 1,Uncertain 和 Bad 混在一起,根本没法做数据清洗。
时间戳更麻烦。PLC 本地时钟漂移,每天差几百毫秒。NTP 对时又受网络抖动影响。IEEE 1588 PTP 能到亚微秒,但交换机得支持透明时钟。产线里大多数设备只支持 NTP,精度几十毫秒。如果做运动控制分析,这根本不够。所以时间戳要分两层:设备时间戳(源时间)和网关接收时间戳(到达时间)。查询时可以用源时间,诊断时看差值。别只留一个。
还有时区。夏令时切换那一小时,本地时间会重复。有一年欧洲工厂切换冬令时,MES 里同一个时间戳出现了两次,追溯报表直接乱了。存 UTC,显示时再转本地。这是血泪。
存储介质与掉电:SSD 不是随便买的
 存储介质与掉电:SSD 不是随便买的
产线环境,粉尘、振动、温度 0 到 55 度,有些柜内能到 70 度。消费级 SSD 的 TBW 和掉电保护根本不够。算一下寿命:假设每天写入 100GB,SSD 容量 1TB,DWPD 1,寿命约 5 年。但如果写放大 3 倍,实际每天写入 300GB,寿命不到两年。而且小文件、随机写、没有 TRIM,写放大更夸张。
工业 SSD 要关注:掉电保护(PLP)、宽温、SLC/MLC 或带 pSLC 的 TLC、DWPD、TBW。有些产线用 CFast 卡,便宜,但写几个月就坏。换成 industrial SSD 后,还要配 UPS 或超级电容,保证掉电时能完成 flush。文件系统别用 ext4 默认 data=ordered,可以考虑 data=journal 但性能下降;或者用 F2FS、littlefs 对闪存友好。数据库层面,WAL 和 fsync 策略要权衡。每秒 fsync 一万次,SSD 也扛不住。批量提交,比如 100ms 一次,能显著降低压力。但掉电可能丢最后 100ms。看工艺能不能接受。
那些不是技术但会要命的细节
数据保留策略。很多工厂存储无限增长,最后磁盘满了,写入失败,报警没人看。设置分区,按天或按周滚动。热数据 7 天,温数据 3 个月,冷数据归档到对象存储。查询接口要支持下采样,别把 10ms 原始数据直接丢给前端画图。前端会卡死。
还有权限和审计。谁改了保留策略?谁删了批次数据?制药和汽车行业有 FDA 21 CFR Part 11、IATF 16949 追溯要求。操作日志要不可篡改。别用 root 跑数据库。
结论?没什么结论。产线数据存储就是一堆权衡。你得知道数据从哪来,到哪去,中间断了怎么办。先保证不丢,再谈分析。先保证确定性,再谈性能。半夜报警少一点,比什么架构图都实在。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:产线数据存储:从10ms扫签到掉电丢数,一个老工程师的踩坑笔记
文章链接:https://m.yqhljx.com/list_9/5883.html
