摘要:产线状态实时查看不是买个组态软件就完事。它牵扯到传感器频带、PLC扫描周期、边缘计算、时间同步、时序库和可视化。这篇文章从机械设计视角,把几个容易翻车的工程细节摊开讲。
先别急着买大屏,时间戳对不上全是白搭
说实话,我第一次做产线状态实时查看的时候,觉得这事简单。PLC里本来就有设备运行信号、故障字、产量计数。通过OPC UA或者Modbus TCP捞出来,往数据库一写,Grafana一挂,齐活。对吧?结果现场一跑,怪事来了:明明A工位先停机,看板上却显示B工位先报警。排查了两天,发现是网关轮询周期不一致,加上PLC系统时间和服务器差了12秒。
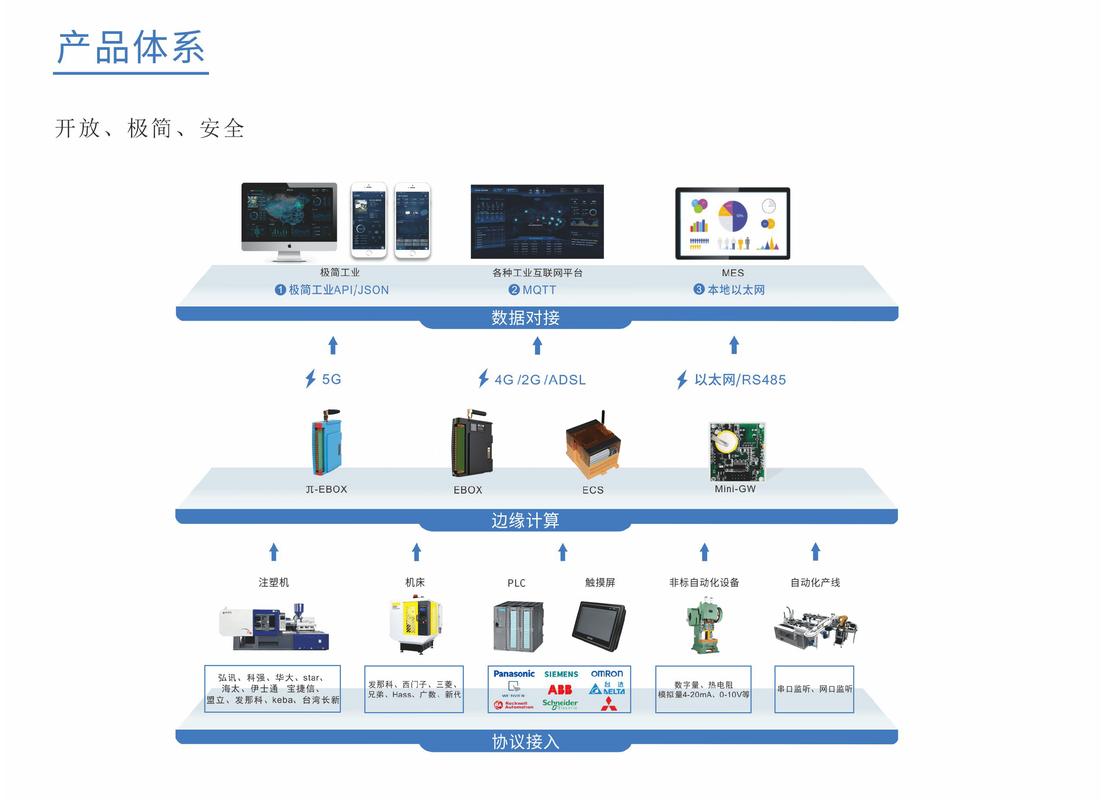
所以,时间同步必须放在最前面。如果是PROFINET网络,可以用IEEE 1588 PTP,精度能做到亚微秒级;普通以太网,至少上NTP,同步周期建议小于64秒。但别以为NTP就万事大吉。有些老PLC的时钟晶振漂移一天能到几秒。这时候,边缘网关要打硬件时间戳,而不是等数据到了服务器再打。否则,你看到的“实时”只是服务器收到数据的时刻,不是产线事件发生的时刻。
还有一个坑:不同协议的时间戳精度不一样。Modbus TCP没有时间戳,OPC UA有SourceTimestamp和ServerTimestamp。如果混用,必须统一到同一个时基。我现在的习惯是,所有采集点先经过一个边缘节点,由它统一对齐到PTP/NTP,再发往上层。多花几千块网关钱,省下的是扯皮时间。
传感器选型:别拿低频电流去猜轴承故障
机械工程师最容易犯的错,是觉得“设备状态”就是几个开关量。运行/停止、开/关、有料/无料。这些当然要,但远远不够。产线状态实时查看真正的价值,在于提前发现劣化趋势。比如轴承内圈剥落、皮带打滑、气缸内泄、丝杠润滑不良。这些故障在早期,往往表现为振动、温度、电流的细微变化。
振动传感器怎么选?先看频带。ISO 10816-3(现在并入ISO 20816)给的是振动烈度评价,适用于10 Hz到1 kHz的机器。如果你要测轴承早期故障,特征频率可能在2 kHz到20 kHz,甚至更高。这时候用IEPE加速度计,灵敏度100 mV/g,采样率至少25.6 kS/s,才能覆盖10 kHz分析带宽。别拿一个4-20mA的振动变送器去干这活,它输出的是RMS值,频带窄,只能看整体烈度。
温度也是。PT100三线制在工业现场很常见,精度0.1°C到0.5°C。但如果你要监测电机绕组,用红外或者埋置PT100差别巨大。还有,采样率不是越高越好。温度变化慢,1 Hz足够。振动可能要25.6 kHz。如果全都按高频采,数据量爆炸。我见过一个项目,30个振动点全开51.2 kS/s,一天产生2 TB原始数据。后来改成边缘特征值提取,只上传RMS、峭度、包络谱峰值,数据量降到20 GB。
安装位置同样要命。磁吸底座方便,但高频响应差,容易在1 kHz以上衰减。M6螺栓安装,表面平整,加耦合剂,能到10 kHz。如果测的是低速重载轴承,比如回转窑,特征频率可能只有几Hz,那就得用电涡流位移传感器,而且要注意被测面材质和表面粗糙度。选型没有万能公式,得先算特征频率。

从PLC到看板,中间隔着一道数据清洗
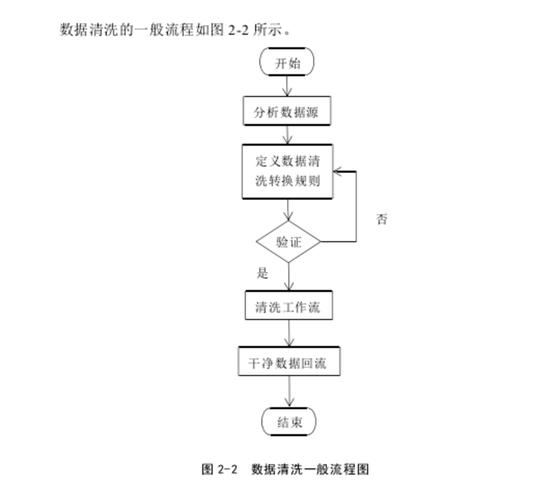
数据采上来就完了?早着呢。PLC里的变量名可能是DB10.DBX0.0,含义只有电气工程师知道。你要把它变成“1#冲床 滑块下死点 到位”。这中间需要一个信息模型。OPC UA的好处就在这里,它有类型系统和地址空间。但很多工厂的PLC还是老S7-300,走S7协议,那就得靠网关做映射。
清洗规则要提前定。比如设备状态,原始值可能是0、1、2、3。0是停止,1是运行,2是故障,3是待料。看板上不能直接显示数字。还有抖动。机械开关量在临界点会快速跳变,比如气缸磁性开关,一秒跳十几次。如果直接写库,时序数据库会被垃圾数据塞满。做法是加去抖,硬件RC滤波,或者软件上连续3次采样一致才认。更稳妥的是用PLC里的TON定时器,20 ms到100 ms,根据工艺定。
还有一个经典问题:数据新鲜度。看板上的“实时”到底延迟多少?如果走OPC UA订阅,发布间隔100 ms,网络抖动20 ms,边缘处理30 ms,数据库写入10 ms,前端刷新1 s。那端到端延迟大概1.16 s。对于大多数产线状态查看,够用。但如果你要做安全联锁,那必须走硬线或者PROFIsafe,不能依赖上层看板。别把可视化系统当安全系统用,这是原则。
OEE不是算出来的,是设计出来的

很多老板一上来就要OEE。OEE = 可用率 × 性能率 × 合格率。公式简单,但数据来源必须可靠。可用率看停机时间,性能率看节拍,合格率看质检。如果停机原因靠人工补录,那OEE就是故事会。我的建议是,先做设备状态实时查看,把自动停机、故障、待料、换型这些状态分清楚,再谈OEE。
具体怎么分?至少要有几个信号:设备运行、设备故障、计划停机、非计划停机、待料、换模。PLC里通常有故障字,但故障字不一定覆盖所有停机。比如卡料,可能只是电机电流升高,然后操作工拍急停。这时候就要结合电流和速度信号。我做过一个冲压线项目,用主电机电流RMS和滑块速度做特征,卡料识别准确率能到92%。但前提是,采样率要够,电流用1 kS/s,速度用编码器脉冲。
还有,标准要统一。ISO 22400-2定义了KPI的术语和计算。如果你们厂和集团报表口径不一样,天天开会吵。最好在项目初期就把状态字典定下来。别小看这个,我见过两个车间因为“计划停机”是否包含用餐时间,吵了三个月。
落地案例:一条冲压线的实时状态改造
去年帮一家汽配厂改冲压线。原来只有三色灯和人工报表。问题很典型:设备突然停,班长跑过去看,发现是传送带卡料。但为什么卡?不知道。改造目标很明确:产线状态实时查看,延迟小于2秒,能区分故障、待料、换模、计划停。
方案不复杂。每台压机加一个边缘网关,采集主电机电流、滑块编码器、气路压力、润滑压力、PLC故障字。电流用霍尔传感器,0-100 A,输出4-20mA,网关采样1 kS/s。滑块位置用编码器分频,每转1024脉冲。振动?只在关键轴承座加IEPE,采样25.6 kS/s,但边缘只提特征值。数据通过OPC UA发到服务器,时序库用InfluxDB,看板用Grafana。总成本不到十万。
踩的坑?有。第一,霍尔传感器安装在主电机动力线上,初始位置没对准,电流波形畸变。后来调整了安装间隙,按说明书要求2 mm到3 mm。第二,网关的NTP没配好,时间漂移导致停机和电流事件对不上。第三,Grafana默认刷新5秒,操作工嫌慢。改成1秒,但查询压力大,后来用了降采样和缓存。
效果呢?三个月后,非计划停机时间下降了18%。主要是因为卡料识别提前了。以前卡料后要等操作工发现,现在电流异常升高0.5秒内就推送。当然,也有误报。比如换模时电流也会波动,后来加了换模信号做互锁。所以,实时查看不是目的,闭环处理才是。
结论

产线状态实时查看,说到底是一个数据管道工程。传感器决定上限,时间同步决定可信度,边缘计算决定成本,可视化决定能不能用。别一上来就追求大屏和炫酷动画。先把时间戳对齐,把状态字典定好,把采样率算清楚。剩下的,就是迭代。
如果你现在正打算做这件事,我建议先拿一条线做试点。别贪多。买个好点的边缘网关,支持OPC UA和PTP。传感器能用螺栓就别用磁吸。数据库选时序库,别用关系库硬扛。最后,别忘了让操作工参与。他们比任何算法都清楚设备什么时候不对劲。
