上周三凌晨两点,现场电话打过来。P-2101 泵振动保护跳了,整条加氢线停车。
我赶到的时候,DCS 上还留着那条曲线——2.3 秒内从 3.1 mm/s 冲到 11.8 mm/s,然后联锁动作。用户开口第一句:“你们那个 AI 预测系统不是号称能提前两周报警吗?”
这个问题很好。也很扎心。
因为它恰好戳中了 AI设备故障预测 这件事最容易被含糊过去的三个边界:预测什么、用什么信号、报警之后谁来买单。下面这些东西,是我这些年做状态监测和预测性维护攒下来的经验,不系统,但都是真金白银换的。
先把问题拆开:检测、诊断、寿命预测不是一个东西
很多方案文档喜欢把它们打包叫“智能运维平台”。可从建模角度看,这是三个数学结构完全不同的任务。
异常检测是无监督的:只知道正常长什么样,输出一维健康指标(Health Indicator)或异常分数。
故障诊断是多分类:输入一段信号,输出“内圈剥落 / 不对中 / 松动 / 汽蚀”。
剩余寿命预测(RUL)最难。它要求你给出退化外推,误差还得以“天”为单位报给维修计划。
三者对数据的要求差着数量级。第一类,几百小时正常运行数据就能起步;第三类……说实话,没有三到五条完整的 run-to-failure 轨迹,任何深度模型都是在拟合噪声。这不是模型能力问题,是信息量问题。
信号这一层做错了,后面模型再花哨都是在灌水
先说采样。ISO 13373-1 和多数厂商手册都会告诉你,滚动轴承早期缺陷激励的是 1 kHz~20 kHz 的结构共振带,所以加速度采样率下限通常取 20 kHz 以上,工程上常见配置是 25.6 kHz。为什么是 25.6 而不是整数 20?因为它能被 2 的幂整除,后面 FFT 点数好取 1024、2048、4096,谱线分辨率算起来干净。
但采样率够,不等于数据有用。
我踩过的坑:传感器用磁吸座,磁座一阶共振正好落在 8~12 kHz。那个频段本来是轴承外圈剥落最敏感的区域,结果全被安装共振污染了。后来改成 M6 螺柱安装,谱图立刻干净——代价是停机两小时打孔、攻丝、涂耦合剂。这笔账,值得算。
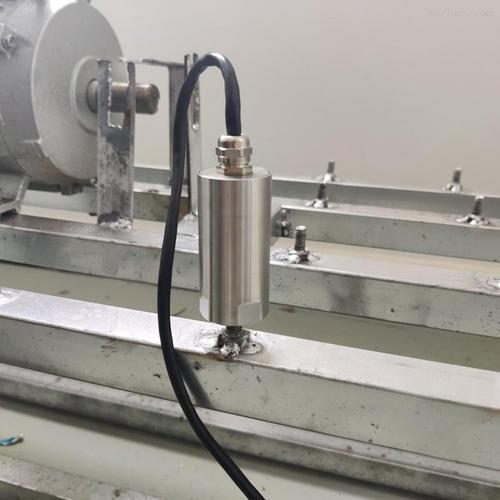
真正关键的动作是包络解调(Envelope Analysis),步骤就三步:带通滤波,把中心频率对准结构共振带(比如 5~15 kHz);对滤波后信号做 Hilbert 变换取模,得到包络;再对包络做 FFT,看低频段有没有冒出轴承特征频率。
滚动轴承四个特征频率有标准公式,以 6308 为例:滚动体数 n=8,球径 d=15.08 mm,节圆直径 D=65 mm,接触角 θ≈0。
BPFO = (n/2)·f_r·(1 − (d/D)·cosθ) = 4 × 49.67 × (1 − 0.232) ≈ 152.6 Hz
其中 f_r 是轴转频。2 极电机在 50 Hz 电网下,2980 rpm 对应 49.67 Hz。

那台泵的包络谱上,152 Hz 幅值三个月内从 0.02 gE 涨到 0.31 gE,而且两侧出现了间隔恰好 49.67 Hz 的边带。边带说明什么?缺陷在载荷区里进进出出,典型局部剥落。六周后拆检,外圈滚道果然有一块约 4×7 mm 的剥落。
要是只看速度有效值呢?同期它一直稳在 2.4~2.8 mm/s。按 ISO 20816-3,中型机组(15~300 kW)、刚性支撑,A/B 区边界就是 2.8 mm/s。也就是说,单靠速度总量指标,这台泵会一直“正常”到彻底抱死。
加速度包络看早期,速度 RMS 看整体,位移看低频(<10 Hz,比如松动、基础刚度不足)。三个量测,三种用途,谁也替代不了谁。
补一句:超低速设备上(<100 rpm),冲击脉冲(SPM)和声发射(AE)往往比振动灵。转速 30 rpm 时 BPFO 可能只有 1.5 Hz,采样窗口要拉到几十秒才够谱线,信噪比惨不忍睹。这种场合,老老实实上油液分析和温度趋势,别硬刚振动。
标签才是真瓶颈,不是模型
这点我得说重一点。
公开数据集就那么几个:NASA C-MAPSS(航空发动机仿真)、FEMTO/PRONOSTIA(轴承加速退化)、XJTU-SY(西安交大全寿命轴承)、IMS(辛辛那提)。都是试验台上、恒定工况、单一故障模式跑出来的。
真实工厂什么样?工况漂移——一台循环水泵白天满负荷、夜里半负荷,转速和载荷都在动;复合故障——不对中引发轴承偏载,轴承磨损又导致松动,几个缺陷叠在一起;变频驱动——VFD 的 PWM 载波在电流和振动里引入干扰,转速还在动态变化。
变速工况下,必须做阶次分析(Order Tracking):拿键相(Keyphasor)信号把时域重采样成角度域,否则谱线全是糊的。这步不做,喂给神经网络的所谓“特征”就是垃圾。Garbage in, garbage out,老话不过时。
那标签从哪来?几个务实的路子。
一个是用物理模型生成退化约束。轴承的裂纹扩展、齿轮的磨损速率,都能给出量级判断,用它约束模型输出范围,比纯数据驱动可靠。物理信息神经网络(PINN)被提得很多,本质上就是把这类先验塞进损失函数的一项。
再一个是迁移学习。试验台数据预训练,工厂少量样本微调。但微调的层数别贪多——我试过,样本量小于 200 条时全量微调几乎必然过拟合,验证集上漂亮,上线就崩。
还有一条,别硬上深度学习。如果手上只有 5 条完整失效轨迹,一个带随机效应的指数退化模型,或者 Weibull 状态模型,完全可能打得过 LSTM。我见过太多论文在 20 条样本上刷出 R²=0.98,到现场一塌糊涂。
报警策略:误报的代价,常常比漏报还高
这是最容易被算法工程师忽略的部分。
测试集上把召回率拉到 95%、误报率 10%,看着很漂亮。可一台关键机组一年触发 36 次误报意味着什么?每次都要派人核查、写报告、跟生产调度扯皮。三次之后,操作工就把报警静音了。这时候漏报率是多少已经不重要——系统死了。
所以阈值设计必须带成本视角。误报成本 C_FP 是停机核查人工加潜在产量损失;漏报成本 C_FN 是非计划停机加二次损伤加安全风险。关键机组上,C_FN 常常是 C_FP 的 10~50 倍,宁可偏保守。但保守不等于迟钝,工程上常见的做法是双阈值加趋势确认:
预警级——超过基线 1.5 倍且连续 3 次采样成立,推到运维看板,不声张;报警级——超过 ISO 20816-3 的 B/C 边界,或包络谱特征频率幅值 30 天涨幅超过 200%,生成工单;跳机级——交给原有保护系统,AI 不碰。
让 AI 去动联锁,是我见过最危险的做法。
另外,模型得监控自己的输入分布。工况变了、传感器松了、线缆断了,模型可能输出一个“非常正常”的值,因为它见过类似的数值形态。所以输入端要有独立的合理性校验:通频 RMS 与包络能量的一致性、传感器偏置电压、通道间相干性。这属于 MLOps 范畴,但在设备预测里,它的优先级比模型本身还高。
一份能落地的清单
如果让我给中等规模工厂提建议,大概是这样:
先从关键机组(A 类设备)起步,5~10 台,别贪多。传感器配置:加速度(25.6 kHz 采样,包络带宽 1~20 kHz)加速度(10 Hz~1 kHz)加温度加键相,缺一不可。
边缘侧做特征提取和一级判断,只上传特征值和异常片段。原始波形全传云端?带宽和存储费会让你怀疑人生。
通信走 OPC UA 或 MQTT,直接对接现有 CMMS,工单要能自动生成——不能生成工单的预测,等于没预测。
前 6 个月用基于阈值的规则加专家复核打底,模型只作辅助。等积累了至少 3 次真实故障的完整数据,再谈模型迭代。每季度做一次误报复盘,这个会议比任何调参都值钱。
结论
AI设备故障预测不是把数据丢进模型就完事的事情。它更像一条工程链条:传感器怎么装、采多快、做什么变换、特征频率算得对不对、标签从哪来、阈值怎么定、误报谁来扛。链条上任何一环断了,模型输出就是一堆好看的曲线。
物理是骨头,数据是肉。缺了骨头,肉立不住。
最后补一句:那天跳机的泵,包络谱三个月前其实已经报出来了。系统画了,没人看。这大概是所有预测性维护项目里最常见、也最不体面的失败方式。
