2026-11-13 03:47:19 分类:机械设计
上周帮苏州的一家注塑机厂调设备,他们之前砸了20万上的云监控平台,传一次模腔压力数据要120ms延迟,碰到飞边毛刺根本来不及调模。
糟心。
很多人聊边缘计算,张口就是”云边协同””算力下沉”的大词,真到车间里落地的时候,全是没人提前说的细节。
为什么车间里的云计算根本救不了急
那家注塑机厂的工艺工程师跟我吐槽,之前为了监控模腔压力,给每台注塑机装了1kHz采样率的压力传感器,每帧数据16bit,单台设备一天产生的原始数据就有2.7GB。最开始他们把所有数据都通过厂区5G专网传到公有云平台,端到端延迟实测在110ms-180ms之间。
碰到模温小幅波动导致的飞边,等云平台算出来调整指令发回机台,已经产出了30多件带飞边的废品。
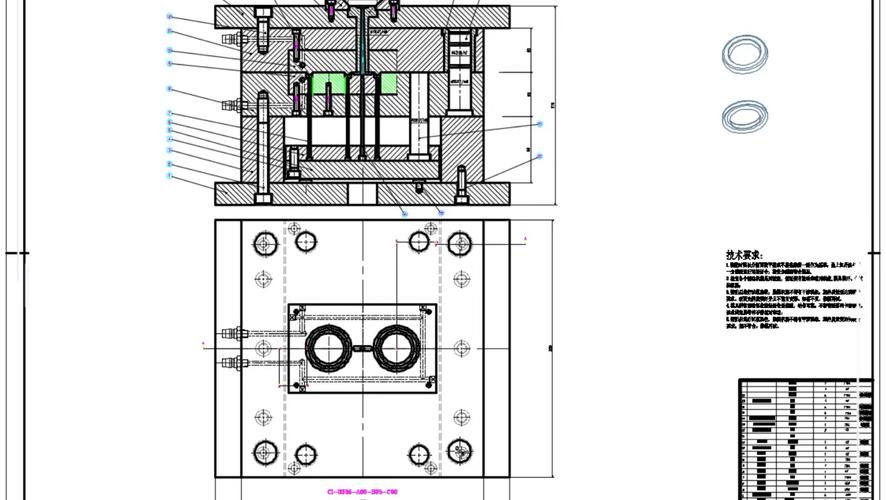 注塑机模腔压力采集边缘节点部署图
你说这钱花得冤不冤?
其实我们做机械设计的都懂一个基本逻辑:闭环控制的响应带宽是硬指标,根本绕不开。GB/T 33009.1-2016《工业自动化系统与集成 工厂通信网络 第1部分:参考模型》里明确划定了,高速运动控制回路的端到端延迟必须小于50ms,这个阈值是硬杠杠,靠公网或者专网连云的方案,物理上就达不到——毕竟光数据在厂区交换机、运营商核心网、云平台服务器之间的路由转发,就得吃掉几十毫秒的延迟余量。
很多人对边缘计算的理解,就是”把云的服务器搬一点到车间墙角”,根本不对。边缘计算的核心本质,是把需要实时响应的计算任务,挪到离传感器、执行器物理距离最近的地方,把本来要绕远路的计算链路压短到几米甚至几十厘米,从物理层面把延迟打下来。
真落地的时候,那些没人提前说的选型权衡
我3年前第一次给一条1600吨冲压线选边缘节点的时候,就踩过一个巨坑。
当时选了个标称算力8TOPS的通用ARM架构盒子,销售拍着胸脯说”跑振动诊断算法完全没问题”。结果真到现场,跑10kHz采样率的冲压冲击波形FFT计算,算一个1s的波形片段要230ms,根本跟不上采集节奏。
后来拆了手册才发现,那个标称的8TOPS是INT8量化的神经网络峰值算力,对我们做机械故障诊断常用的时域FFT、冲击特征提取这类计算,实际有效算力只有标称值的17%。
 冲压线振动故障诊断边缘计算算力测算表
我当时盯着示波器上的延迟曲线,差点把手里的万用表摔在地上——说好的毫秒级响应呢?合着都是PPT上印的数字?
现在我们团队选边缘节点,已经形成了三个不写在标书里的硬标准,谁选设备都得照着来:
第一,必须满足工业级温宽要求,-40℃~85℃的工作温度范围,防护等级不低于IP40,符合GB/T 15969.2《可编程序控制器 第2部分:设备要求和试验》的环境规范。别拿消费级的家用盒子往车间塞,夏天车间里炉边温度能冲到45℃,消费级硬盘连续跑3个月就得挂,到时候丢了工艺数据,谁都担不起责任。
第二,算力必须实测,不能看标称值。我们现在的测试标准很简单:给设备发一段1024点的工业总线采集数据,算一次FFT的时间必须小于1ms,达不到的直接pass。标称算力的参考价值,在工业现场的实际算法面前,往往连两成都不到。
第三,必须带本地存储的掉电保护模块。之前有个合作的零部件厂,边缘节点存了3个月的模具磨损工艺数据,赶上车间临时跳闸,没有掉电保护的节点直接把闪存里的数据冲了,老板追着项目组骂了整整半个月。
不过话说回来,边缘计算也不是什么场景都要上。比如那种一年才采集一次的设备空载能耗统计,数据量小,对延迟没任何要求,你花大几千块钱上边缘节点,纯纯是浪费钱。我见过最离谱的项目,给仓库的照明开关装边缘计算节点,算下来硬件成本是照明系统本身的3倍,图啥呢?
算过账才知道,边缘计算到底省在哪
还是之前那家注塑机厂,后来我们给他们做了改造方案,在每台机的采集端加了工业级边缘节点,把原来全量上传的数据做本地清洗:把稳态生产阶段的正常模腔压力数据,压缩到原始数据量的8%,只把异常波动、飞边报警、模温超标的结构化数据传到云端。
算个账给你听:
改造前,20台注塑机每年的云带宽费是12.8万,云存储费是4.2万,因为延迟导致的废品损失一年差不多27万。
改造后,带宽费直接降到每年1.9万,云存储费降到0.7万,最关键的是,本地闭环调模的响应延迟压到了22ms,废品损失一年降到3.2万。
整个改造项目的硬件加调试成本是18万,算下来11个月就收回了全部投入。
我当时在现场调程序的时候,特意在边缘节点上留了个本地的小显示屏,操作工不用登云平台,在机台旁边就能看到实时的模腔压力曲线。上次碰到个干了22年的老师傅,看完界面跟我说,这东西比之前的云平台好用太多——毕竟他不可能站在控制台前面,隔两分钟就掏手机刷一下云平台的告警啊。
很多人吹边缘计算的时候,总说”断网也能正常运行”,其实我们实际落地的时候,根本不是为了断网准备的。边缘节点做的事,本质上是分工:实时的闭环控制、数据清洗这些对延迟敏感的任务,放在本地跑;长期的模具磨损趋势分析、能耗成本核算这些不需要实时的任务,还是放在云端跑。两边各干各擅长的事,谁也不抢谁的活。
最后说点掏心窝子的。
边缘计算从来不是什么飘在天上的新概念,本质上就是我们机械工程师天天挂在嘴边的”就近匹配”逻辑。就像你设计传动系统的时候,不可能把减速器装在离电机10米远的地方,不然传动误差大到根本没法用;计算链路也是一样,数据从传感器出来,你非得绕几公里传到公网的服务器上算,算完再传回来控制执行器,这个路径本身就跟工程逻辑拧着来。
别被那些吹得神乎其神的概念晃花了眼。
所有工程上的技术方案,最后都要落到账上、落到现场的实际问题上——能把废品率降下来,能把响应速度提上去,能让一线的操作工用着顺手,这就是好方案。
免责声明:市场有风险,选择需谨慎!此文仅供参考,不作买卖依据。如有侵权请联系删除。
文章名称:工业现场落地3年:边缘计算的真坑、真省和选型实账
文章链接:https://m.yqhljx.com/list_9/5731.html
