摘要:本文分享笔者近十年做智能立体仓储项目的实际落地经验,针对中级工程师在设计选型、调试运维中常踩的坑,结合行业规范给出可落地的参考,避开供应商的营销陷阱。
核心逻辑不是堆设备,是匹配你的货流
很多刚接触这个领域的工程师,上来就堆配置。要最高的堆垛,要最多的货位,要最贵的AGV。
不对。
前年接了华东一家汽车零部件厂商的智能立体仓储改造项目,客户一开始拿着供应商给的方案,说要做12000个高层货位,存储密度能做到0.8个每平方,听起来很美。我们进场做货流统计,三天就发现不对。
这家厂62%的出货是给整车厂做JIT配送的小件冲压件,月周转次数超过13次,只有不到20%的模具、备件是月周转低于1次的慢转存货。如果把所有货都塞进18米高的堆垛巷道,单次出入库的平均等待时间超过2.7分钟,根本赶不上JIT的节拍要求。
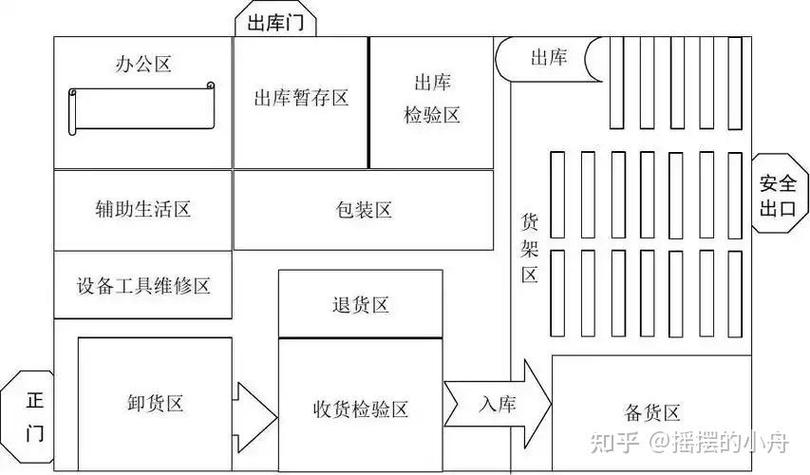
按照GB/T 28576-2012《自动化立体仓库设计规范》的要求,设计的第一步必须完成存储单元划分与周转率分类,很多方案直接跳过这一步,上来就做硬件,能不出问题吗?
我们当时顶着客户的压力把原设计推翻,改成快慢分储的结构:快转小件放在二层穿梭车货架区,管理系统做周转率分层调度,优先分配近出入口的货位,慢转的模具备件才放到高层堆垛区。最终货位总数降到了9600,比原方案少了20%,但出入库周转效率直接提了48%,客户后来给我们介绍了好几个新项目。
调度算法选型:别吹AI,稳定才是硬道理
说实话,现在行业里的营销风太盛。只要沾智能两个字,什么都要往大模型上靠。上次碰一个供应商给客户报方案,说调度用了千亿参数大模型,能动态优化路径,报价比常规方案贵了30万。
客户拿不定主意来找我看,我算了一下他的仓:一共才3200个货位,12条巷道,单日最大出库量才800单。你说,这么小的体量,要什么大模型调度?
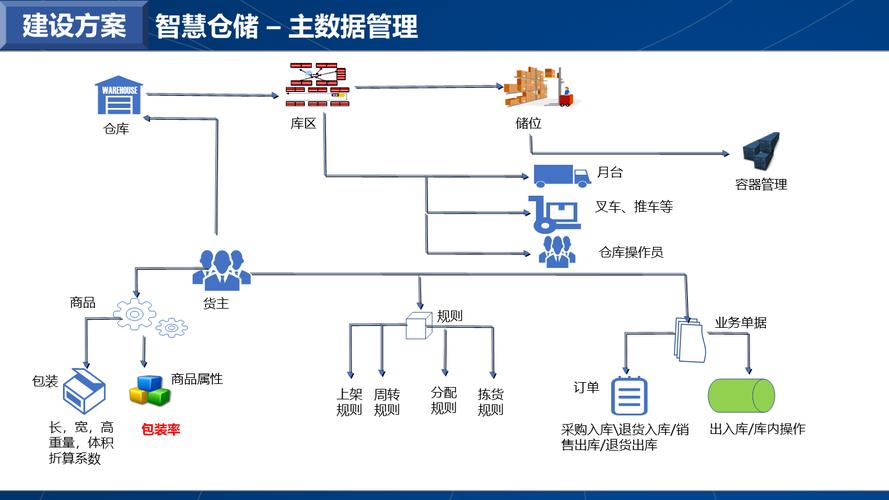
路径规划的瓶颈永远是巷道和堆垛机的数量,不是算法的参数大小。我做过对比测试,同样10条巷道的仓,传统的遗传算法加禁忌搜索的调度方案,和所谓大模型动态调度的效率差不到3%,但前者的授权成本不到后者的十分之一,还不会出现大模型偶尔犯傻调度冲突的问题。
不过话说回来,不是说AI完全没用。如果你的仓是超过2万货位的多温区电商仓,每天出入库超过10万件,那大模型调度确实能提几个点的效率,这个钱花得值。大部分中小项目,真没必要凑这个热闹。
我还踩过一个坑,刚做项目那会,没注意不同厂商硬件的协议适配,管理系统的调度模块只做了PROFINET的对接,客户的堆垛机是老设备用Modbus RTU,结果上线前连续三天都有调度指令丢包,整个团队在现场蹲了三个通宵改协议适配层,现在想起来还腿酸。
运维阶段最容易忽略的隐形坑
很多人觉得系统上线验收就完事了。哪有这么好的事。
去年广州一个客户找我,说他们的智能立体仓储管理系统上线五年,现在越来越慢,每次月底盘库要跑四五个小时,刚上线的时候只要二十多分钟,以为是服务器老化,换了新服务器还是慢。
我上去一看数据库,嚯,攒了快220G的冗余数据,从上线第一天的调试日志到五年前早就清掉的SKU历史数据,全存在在线数据库里,能不慢吗?
按照GB/T 37989-2019《智能仓储管理系统技术要求》,明确要求系统必须支持历史数据自动归档,超过3年无流动的库存数据要转离线存储,很多项目交付的时候根本没给客户做这个配置,客户的运维也不懂,时间长了就卡成狗。
还有一个常见的坑,就是RFID标签的绑定更新。很多客户换了产品SKU,直接贴新标签,旧标签没在管理系统里解除绑定,结果堆垛机取货的时候,扫到同一个货位两个标签,直接报错停线,我碰到过三次因为这个问题导致的停产,每次都要花大半天理数据,你说离谱不离谱。
智能立体仓储这行,做的越久越不敢瞎炫技。合适比先进重要,匹配你的业务比什么都强。多去现场盘一周货流,比坐在办公室看十份营销方案有用得多。
