上周去苏州某汽车零部件厂做调试,对方掏出来一摞半年的振动监测记录,说花了120万上的整套设备状态监控系统,愣是没提前报过一次轴承故障——所有报警全是误报,要么是车间行车过的时候电磁干扰触发的,要么是阈值设得太敏感,稍微有点正常波动就跳弹窗。
离谱吧。
我蹲在现场翻了一下午的安装记录,发现问题根本不是系统不好,是从选型到设置全走了样。
传感器选型:别盯着IP68就直接下单
很多人选监测传感器,第一反应是找防护等级最高的,IP68,耐温范围越宽越好,价格越贵越靠谱。真到了现场,根本不是那么回事。
之前见过个项目,给循环水泵的轴承座选振动传感器,采购盯着参数表选了款标称IP68、工作温度-40~85℃的MEMS加速度计,觉得参数够顶。结果夏天车间西晒,轴承座表面温度直接冲到87℃,传感器零点漂移了20%,测出来的振动值比实际值高一倍,天天误报。等把传感器拆下来换了,才发现标称的温度区间是25℃环境下测的,根本没考虑轴承座的传导热。传感器的额定工作温度区间必须留至少15%的冗余量,尤其是安装在热源附近的点位,绝对不能卡着临界值选。
还有个更常见的坑:为了省成本,用测建筑结构振动的普通MEMS传感器去测滚动轴承的早期故障。这类传感器的频响上限一般只有1kHz,但是滚动轴承出现点蚀、保持架磨损的早期冲击信号,集中在2kHz~10kHz的高频段——信号根本传不到传感器的输出端,系统自然显示一切正常。等能被MEMS捕捉到的低频振动涨上来的时候,轴承已经快散架了。
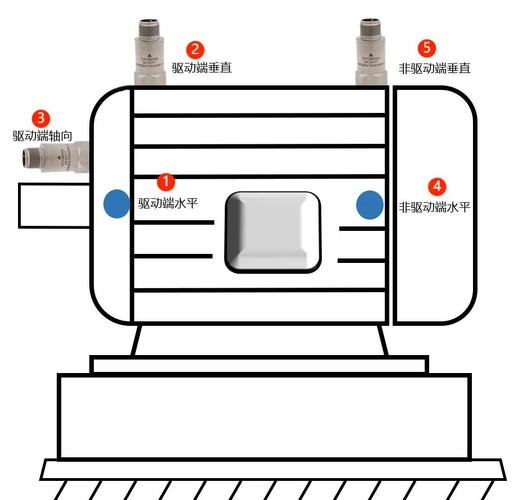
我上次碰到个工程师,踩的就是这个坑。他给车间27台离心泵全装了便宜的MEMS传感器,连续三个月系统显示“运行正常”,直到有台泵的轴承碎了,把端盖打穿,漏出来的润滑油流到电缆沟里差点引发短路,才反应过来传感器根本没测到有效信号。说起来就来气,省了几千块的传感器成本,换来了几十万的停机损失,这账怎么算都亏。
阈值设置:别直接抄设备手册上的参考值
设备手册上的振动报警值,其实是通用的参考边界。比如按GB/T 6075.3-2022的规定,刚性安装的中型机泵,振动速度有效值在1.8mm/s以下属于优秀区间,4.5mm/s是合格上限。很多人图省事,直接把这个4.5mm/s设成报警阈值,觉得有手册背书,出了问题也不用担责任。
但实际跑过现场的人都知道,全新安装的机泵,正常运行的振动速度可能才1.0mm/s,你设4.5的报警值,得等振动值涨了4倍才会报警——那时候轴承的滚道已经有大面积剥落了,根本没有提前安排检修的窗口期。真正靠谱的报警阈值,从来不是抄手册的固定值,而是基于设备自身运行基线动态设置的。具体怎么做?设备安装调试完成,连续稳定运行72小时,取这段时间的振动均值作为基线,报警值设为基线的3倍,紧急停机值设为5倍。这个灵敏度比通用手册值高至少两个等级,能提前3~7天捕捉到早期故障的信号。
不过话说回来,也不能为了减少误报就把阈值设得太离谱。之前在水泥厂做整改,对方的立窑鼓风机轴承监测,原来的报警值设到了12mm/s,系统连续两年没报过警,直到有次轴承抱死把传动带磨断,整条线停了12个小时。我帮他们把阈值按基线3倍重设,基线是0.9mm/s,报警值设2.7mm/s,过了半个月,系统就报了振动超限的弹窗,拆下来检查发现轴承滚道上已经有两块直径2mm的点蚀,提前安排了停机更换,连备件都没等。
温度监测的阈值设置也是同理。很多人按电机绝缘等级的极限值设报警,比如F级绝缘的最高允许工作温度是155℃(按GB 755的标准),就把报警值设到130℃。但实际运行中,绕组温度每升高10℃,绝缘材料的老化速度就会翻倍,真等到130℃报警的时候,绝缘寿命已经耗掉了近一半。实际设置的时候,把报警值设到95℃,停机值设到110℃,才是真的对设备寿命负责。
数据落地:别让监控数据全躺在硬盘里吃灰
我见过太多厂,花大价钱上了设备状态监控系统,最后就变成了中控室墙上一块跳动的数字大屏,没人真正去看。系统攒了好几年的原始波形数据,硬盘满了就自动覆盖删除,从来没做过趋势分析,更别说靠数据预判故障了。
说白了,设备状态监控的核心从来不是“实时盯着屏幕看数”,而是通过长期的特征值跟踪,拟合设备的劣化趋势,把不可控的非计划停机,变成可以提前安排的计划内检修。比如滚动轴承从首次出现点蚀,到振动值第一次超过报警阈值,大概有2~3周的稳定劣化窗口期——这个时间足够申请备件、协调生产排程,根本不需要半夜紧急抢修。
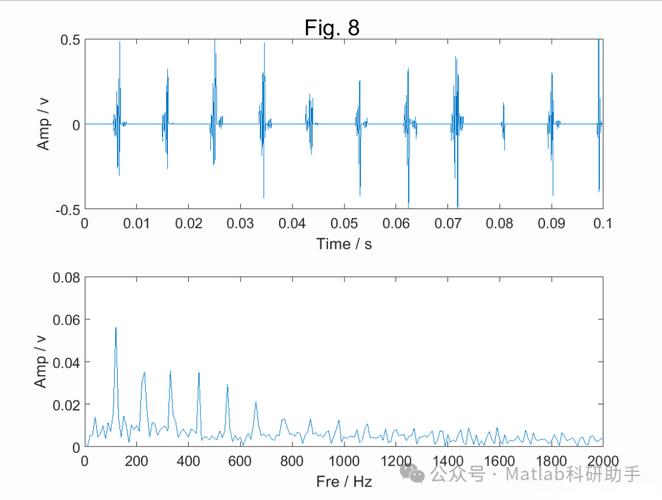
很多人说,存全量的原始波形太占硬盘。其实根本没必要。你不需要把每秒的振动波形全存下来,只要每天固定提取几个核心特征:振动速度有效值、峰值因子、高频冲击能量占比、轴承特征频率的幅值,这些数据存下来,十年的量都占不到10G的硬盘空间。有了这些特征值,你就能清晰看到设备的劣化曲线,根本不会等故障发生了才反应过来。
之前碰到个在水泥厂干了20年的运维老班长,跟我说他们以前的监控系统,每次报警都是“设备快炸了”的级别,现在用了动态阈值加趋势跟踪的方法,已经连续8个月没出过非计划停机了。那种不用半夜爬起来抢修的爽感,跑过现场的都懂。
设备状态监控从来不是什么高大上的数字化噱头。
说白了,就是把以前老运维靠手摸温度、靠听针辨声音的经验,换成可量化、可追溯的传感器数据。
别为了凑项目预算上一堆根本用不上的传感器,别抄手册设脱离现场实际的阈值,别让辛辛苦苦采回来的数据躺在硬盘里睡大觉。
把这几件最基础的事做扎实,比花几百万买的花哨可视化大屏有用得多。
