上周跟苏州某变速箱厂的工艺组喝酒,老周拍着大腿骂——花300万上的数采系统,存了2年的主轴振动数据,现在翻出来连哪台机床、哪个批次的齿轮在跑都对不上,跟看一堆乱码没区别。很多人把工业数据治理当成IT部门的事,装个采集网关、存进云平台就算完事——实际上从机械加工场景摸爬滚打过来的人都知道,脏数据、错维度、断链路这三个坑,能把花了几百万的数采项目变成没人愿意碰的数字垃圾场。这篇就讲我们在重型机床、汽车零部件两条产线摸了3年的实打实干货,没有虚的概念,全是能直接抄的参数和避坑点。
别上来就挖:先把机床侧的“脏数据”筛干净
别信什么“全量采集”。
我们去年在某重型卧车的数采项目里,一开始图省事把西门子840D sl系统里所有能读到的寄存器都做了映射,光主轴相关的采集点就有127个,跑了3个月存了近20T数据,结果翻出来才发现,其中42个点是系统自检的无意义空值,18个点的采样周期被系统默认设成了10分钟——连切削过程的振动峰值都抓不住,谈什么挖掘?
后来我们照着GB/T 33905.3-2017《智能制造 机器状态监测与诊断 数据规范》的要求重新梳理了采集点:主轴振动的采样周期严格卡≤1ms,切削参数(转速、进给、切削力)的采样周期不超过50ms,把那些和实际加工、设备状态无关的空值点全部砍掉,最后剩下的有效采集点只有39个,存储量直接降了70%,数据的可用性反而提了不止一个量级。
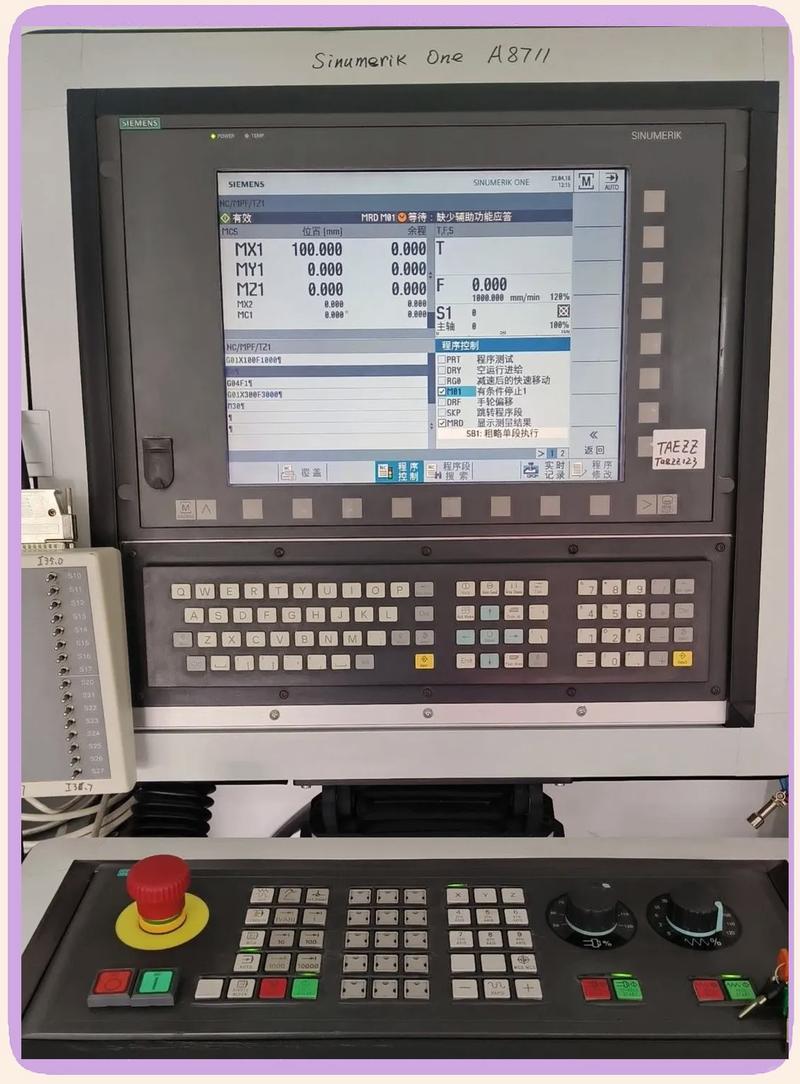
还有个最容易被忽略的——传感器的安装误差。
去年给某高精度磨床厂做砂轮磨损的预测模型,一开始图省事把振动传感器直接拧在了机床床身的固定螺栓上,跑了2个月的数据拟合出来的R²只有0.31,换了位置装在砂轮主轴的轴承座旁边(按照GB/T 6075.3-2019《机械振动 在非旋转部件上测量评价机器的振动 第3部分:额定功率大于15kW、额定转速为120r/min到15000r/min的工业机器》的要求,传感器要尽量靠近振源,安装刚度要≥1e7 N/m),一周的数据就把R²拉到了0.87。
说起来都是泪,当时为了调这个安装位置,在车间蹲了整整一周,手上沾的切削油洗了三天都没洗干净。
维度对齐才是治理的核心:别让数据变成“对不上的孤本”

说实话,我们见过太多产线的数采数据,数采系统记的是2023年6月12日14:23的主轴电流峰值,MES系统记的是14:25开始加工批次号为GB23061204的20CrMnTi齿轮,两边差了2分钟,你怎么关联?
之前有个做汽车零部件的客户,花了大价钱上了数据中台,结果因为各个系统的时钟不同步,整整半年的数采数据都没法和对应的加工批次绑定,最后只能当历史垃圾删掉——几百万的投入打了水漂,说起来都心疼。
我们现在用的是工序级的时间戳对齐机制,不是简单的把所有数据的时间轴拉平,而是在每个工序的开始、结束节点,由机床的PLC主动打一个带唯一工序ID的同步脉冲,不管数采系统、MES系统、质量检测系统的时钟差多少,只要抓到这个脉冲,就把前后10s范围内的所有数据都绑定到这个工序ID上。
别信什么NTP时钟同步——车间里的电磁干扰能把NTP的同步误差拉到30s以上,我上次在某冲压车间蹲了3天,测出来的平均同步误差是17.2s,够冲20个零件了。
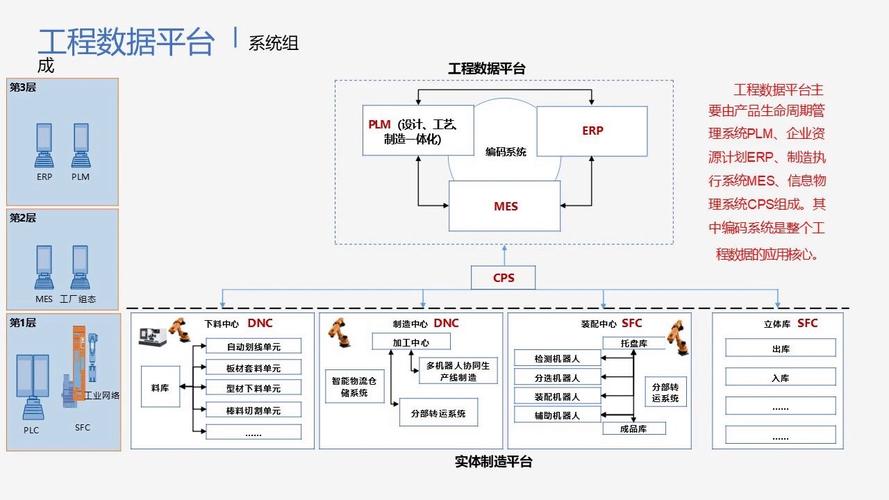
之前帮那个苏州变速箱厂解决同步器齿套的加工质量问题,之前一直找不到是什么原因导致的齿形超差,后来把每个工序的数采数据(主轴转速、进给量、切削液压力、振动值)和对应的三坐标检测结果绑定到同一个工序ID上,跑了3000个零件的数据,挖出来是——当切削液的压力在某一个批次低于0.32MPa的时候,齿形的超差率会从0.2%跳到12.7%。
之前工艺组的人还以为是砂轮磨损太快,折腾了半个月换了三批砂轮,结果超差率一点没降,最后靠数据挖出来的问题,调了切削液的泵压,当天超差率就回到了正常水平。老周后来请我吃了三顿太湖大闸蟹,说比他之前请的咨询公司靠谱多了。
挖数据不是搞算法玄学:要给现场的工程师留“落地接口”
我最烦那种上来就说要搞大模型、搞深度学习的——我们车间里的工艺师傅,连Excel的透视表都用不利索,你给他一个黑箱模型,告诉他“这个零件有87%的概率不合格”,他敢信吗?
我们做数据挖掘的一个基本原则是:所有的模型输出,最终都要拆成可执行的阈值规则。
比如刚才的切削液压力的问题,我们不是给个复杂的回归模型,而是直接在数采系统里加个预警:当切削液压力连续3s低于0.32MPa的时候,直接给现场的工艺员发个企业微信的提醒,附带之前的超差率统计数据。没有复杂的公式,没有难懂的算法术语,现场的人一看就知道该去拧哪个阀门。
还有我们做预测性维护的时候,不是给个“主轴剩余寿命72小时”的模糊结果,而是直接拆成:当主轴的振动有效值超过4.5mm/s(按照GB/T 6075.3-2019的B级警戒阈值),并且连续2小时的趋势斜率超过0.2mm/s每小时的时候,就提醒维修班组在下次换班的时候检查轴承间隙。
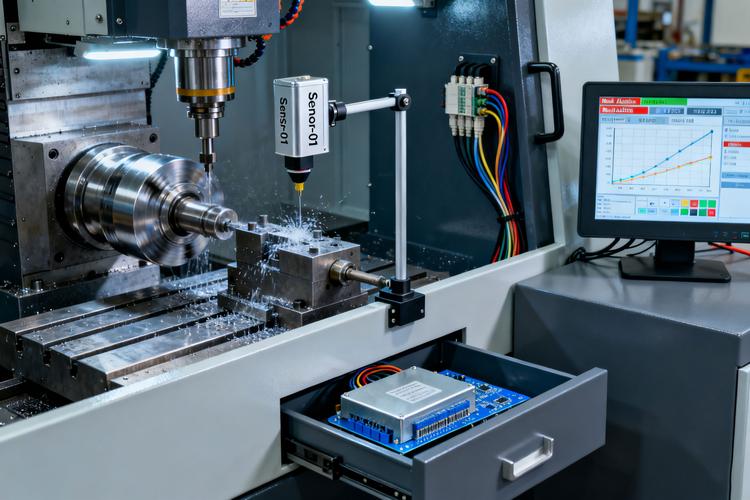
上次有个互联网出身的算法团队给我们做的模型,说能把主轴的剩余寿命预测精度做到95%,结果我们拿现场的实际数据测,发现他的训练集里根本没有考虑夏天车间温度到40度的时候,主轴润滑油粘度下降导致的振动升高的情况——算出来的寿命比实际值高了3倍,差点因为没及时换轴承把一个20多万的CBN砂轮撞废。现在想起来还冒冷汗。
说真的,现场的人不需要多么高精度的黑箱模型,他们需要的是“我现在该干什么”的明确指引。
其实工业数据的深度治理挖掘,根本不是什么高大上的互联网玩法。说白了就是把你在现场跑的时候遇到的那些“说不清楚的偶发问题”,用数据的方式把它们的关联找出来,最后变成能让现场的人少加班、少撞机床、少出废品的实招。别上来就堆硬件、堆算法,先把数据洗干净、把维度对齐、把结果落地——这就够了。
