摘要:本文基于多个机械零部件产线的AI缺陷识别落地项目,拆解了实验室高准确率模型上线翻车的核心原因,给出了工业场景下AI缺陷识别的核心选型指标与成本控制方案,适合准备落地该技术的中级工程师参考。
去年我跟进了国内某汽车供应商底盘冲压件的质检改项目,那是我第一次真的明白,AI在实验室里是一回事,放到产线跑,完全是另一回事。
当时客户原来用的是人工质检,每个班要放8个熟练工,漏检率还一直下不去,老板下定决心要上AI。一开始找了某头部AI厂商的现成方案,实验室用筛选好的标准数据集测试准确率能到99.2%,所有人都觉得没问题。结果上线第一天,就把3%的表面带浮锈的合格件全部打废,还漏检了两个带隐藏裂纹的转向臂支架。
吓出一身冷汗。
从实验室99%准确率到产线不及格,坑在哪?
很多刚接触AI缺陷识别的工程师,第一个误区就是拿实验室的准确率当最终性能。我可以负责任说,工业场景下,脱离了工况的准确率,一文不值。
我们复盘那次翻车,第一个问题出在数据。厂商给模型训练用的标注数据,全是挑出来的干净缺陷样——把缺陷抠出来,放到纯色背景,标得整整齐齐。真实产线是什么情况?冲压件表面会有切削液残留、会有浮锈、会有输送带投下来的光影变化,甚至工人手套上沾的油污蹭上去一点,AI都直接当成裂纹缺陷给打回去。
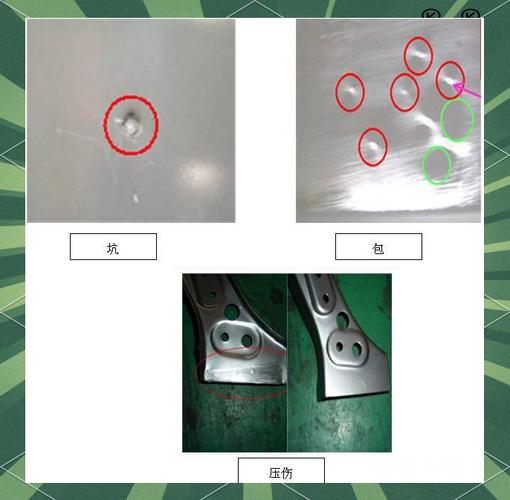
第二个坑,是缺陷的位置和形态根本不固定。冲压模具用个三五天就会磨损,新出的零件毛刺位置跟新模具的时候差了两个毫米,很多固定锚点的模型直接就检测不到了。换个新批次产品,尺寸变了五毫米,整个模型直接废了一半性能。
说实话,那次我们项目组蹲在产线边改了整整十四天,每天跟着工人三班倒,收集了两千多张真实工况的干扰样本重新微调,才把误检率从12%压到1.5%以下。头发掉了一把。
落地级AI缺陷识别,核心要抓哪几个工程指标?
很多人上来就问,你用的是YOLO还是ViT?准确率多少?其实工业落地,核心指标根本不是这个。
第一个必须卡死的指标,是真实工况下的漏检率。尤其是汽车、航空这些安全件行业,按照IATF16949质量体系的要求,安全件的漏检率必须低于0.1ppm,也就是百万件里不能超过1件漏检。误检率高一点,最多就是多一道人工复检,漏检一件,那就是整车召回的大事,这个红线碰不得。
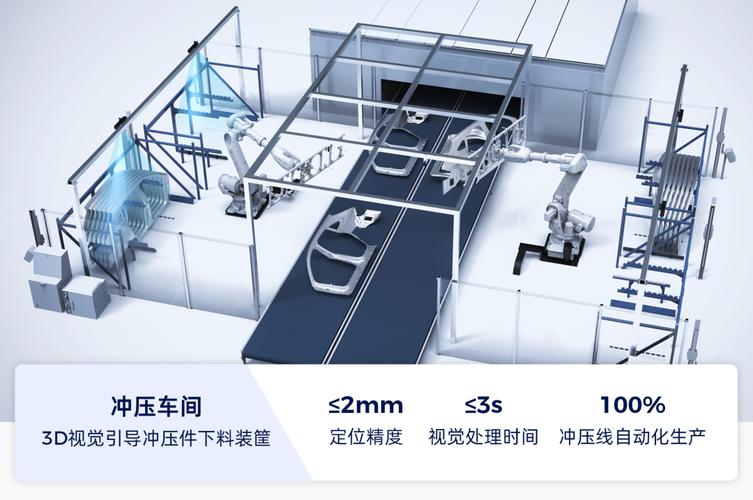
第二个指标,是单帧推理延迟。我见过不少漂亮的模型,300万像素的单张图推理要300多毫秒,产线节拍是每分钟12件,你拍了照AI还没算完,下一件已经过来了,直接乱套。行业通用要求是,单帧推理必须低于100ms,才能适配大多数中小零部件的产线节拍。
再说说模型选型,很多人迷信大模型,什么参数越大越好。不过话说回来,中小零部件产线的缺陷一共就那几类——裂纹、气孔、毛刺、凹坑,改好的YOLOv8足够用,准确率跟大模型差不了一个点,推理速度快三倍,显存占用只需要四分之一,成本降下来不好吗?
还有个很多人忽略的点,就是标注质量。我见过太多项目把标注外包给大学生,标注员根本分不清什么是允许的工艺痕迹,什么是致命缺陷。比如冲压件的拉毛,行业标准是大于0.2mm深度才是缺陷,小于的不影响性能,标注员不管,全标成缺陷,模型能准才怪。做AI缺陷识别,一定要让工厂的老质检参与标注,这个钱省不得。
中小工厂落地AI缺陷识别,怎么控成本?
现在很多AI厂商开口就是几十万一套,吓退了不少中小厂子。其实完全没必要花那个冤枉钱。
第一个降本点,是用半监督标注代替全人工标注。我们现在做新项目,都是先拿100张标注好的典型缺陷样做预训练,然后让模型自动标注剩下的几万张样本,人工只需要改模型标错的部分,标注成本直接降70%还多,准确率跟全人工标注差不到0.5%,足够用了。
第二个降本点,是不要上来就搞云端集群,用边缘推理就够了。大多数中小厂子的产线,也就2-4台相机,一张RTX 3090就能跑2路相机的实时推理,整套硬件下来才一万多块钱,比几十万的云端服务器划算太多,延迟还更低。
别信什么「一次部署终身可用」的鬼话。产线模具天天磨,原材料批次天天变,缺陷的形态位置一直在变,哪有一劳永逸的好事?成熟的方案一定是预留了简单的微调入口,每个月让工厂的质检抽两个小时,更个三五十个新样本,模型性能就能一直保持,这个才是可持续的。
对了,如果你那是多品种小批量的产线,别一开始就想着覆盖所有产品。先挑产量最大、缺陷最稳定的那个品种做,跑通了再慢慢扩,风险小很多,回本也快。
AI缺陷识别本来就不是什么炫技的黑科技,就是个接地气的工程活儿。把工况考虑全,把数据做对,别拿实验室的漂亮数据当幌子,真蹲到产线边把一个个小坑填上,就能用得顺手,就能真的帮工厂省钱省人。
